2026.09.29 | AC | Memory | Muse & Personal AI NAND Upside
原标题:Muse 之后, 十亿个人 AI 能给 NAND 带来多大增量?
摘要
个人代理带来的存储需求包括三部分:长期保存的用户数据、执行与推理集群的工作存储,以及可复用的 KV 闪存缓存。三者增长方式不同,计算时也要避免重复。按笔者假设,单个 Muse 的基准配置存量约 5 EB,重度情景约 40 EB,分别相当于 2026 年全球闪存市场容量的约 0.4%和 3.3%。如果个人代理发展为十亿个保留数据的账户,沿用基准活跃度和使用强度,配置存量约 17 EB。更大的需求来自用户规模扩大、工作量增加和每 GPU 闪存配置提升共同发生。对 NAND 投资而言,值得跟踪的是整类产品的发展,以及其中有多少需求真正转化为新增 SSD 采购。
#
一、任务做完了,用户的数据还在
此前讨论 Muse 对 CPU 的拉动时,笔者采用的是核分钟框架:一个用户每天交给代理多少工作,每项工作消耗多少 CPU 时间,再根据利用率和峰值需求计算服务器规模。
NAND 的计算方式有所不同。
代理完成一次机票预订,执行这项任务的 CPU 可以去处理其他用户的工作;浏览器关闭后,占用的 DRAM 也可以释放。但如果用户留下了行程文件、账单、对话历史和后续安排,这些内容仍然需要保存。
用户今天没有登录,也不影响这部分存储占用。
个人代理使用数月甚至数年之后,会逐步积累文件、偏好和未完成工作。因此,测算存储需求,除了看每天执行多少任务,还要看过去的任务留下了多少数据。
这部分需求可以参考 iCloud、Google 云盘。每个用户实际保存了多少 GB,平台就需要持续为这些数据提供容量。
二、三类存储,分别由什么驱动
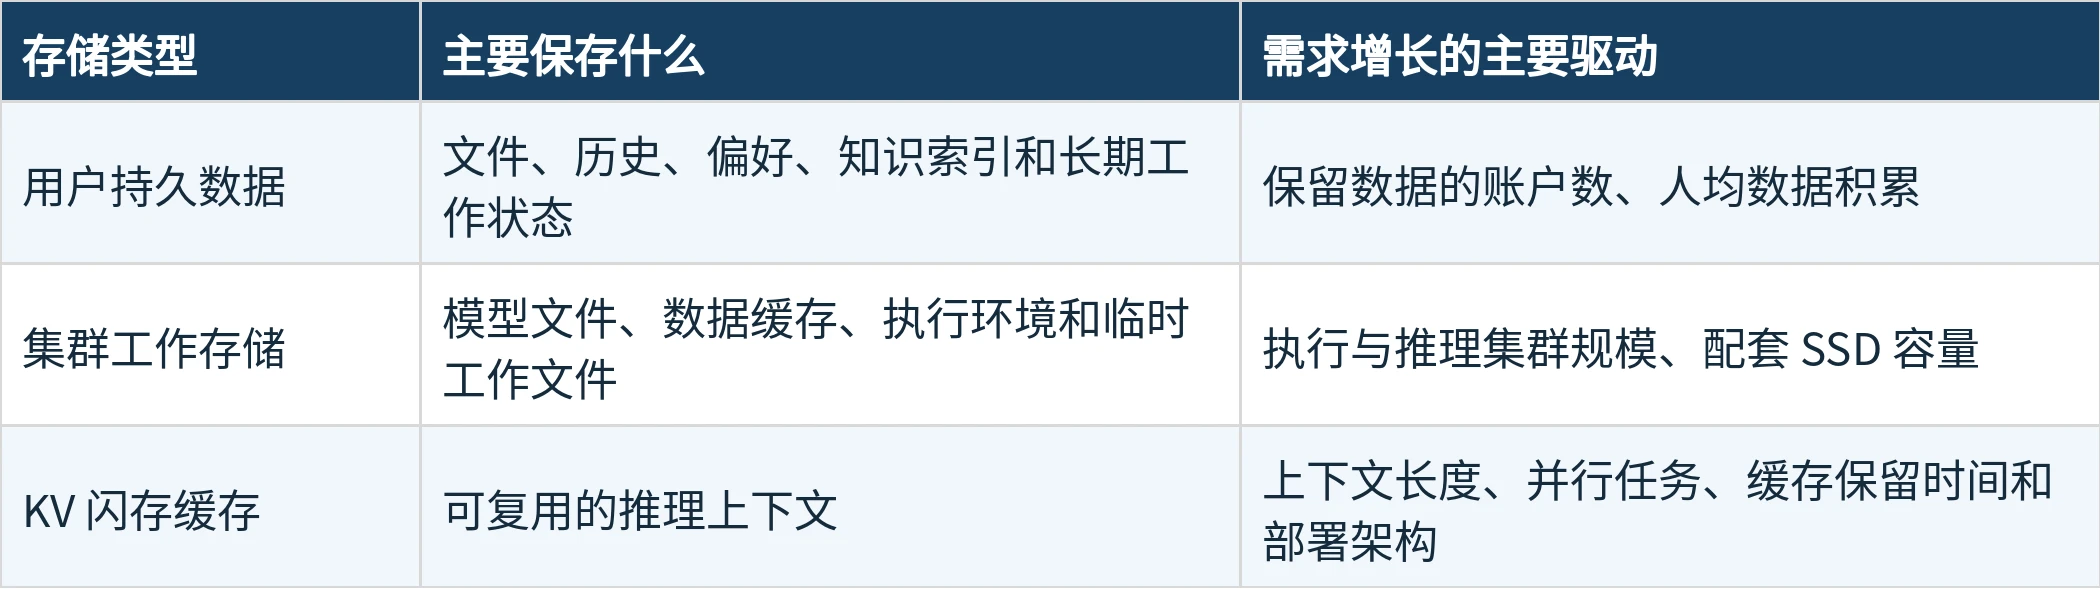
要把这个判断落到 NAND 数量上,可以分成三部分。
表 1 个人代理的三类存储需求
资料来源:笔者整理。
第一部分可以跨任务、跨年度积累。后两部分更接近按工作量配置的资源池,数据可以清理、覆盖和复用。
例如,代理完成一次研究后,最终报告可以长期保存,过程中下载的临时文件可以删除。推理上下文则根据后续复用价值决定保留多久,空间不足时可以淘汰。
这些需求在 ChatGPT 等产品中已经存在。OpenAI 的公开说明显示,ChatGPT 可以保存上传和生成的文件;单独保存在 Library 中的文件,也不会因为删除聊天而自动删除。个人 AI 的持久文件库已经开始形成。
Muse 带来的变化,是代理可能承担更多连续工作,从而扩大这三部分的规模。
三、个人文件,先参考云盘的使用强度
对于普通个人代理用户,笔者暂时没有理由假设其长期文件容量会明显超过照片、视频和设备备份驱动的云盘用户。因此,持久数据先采用比较克制的假设。
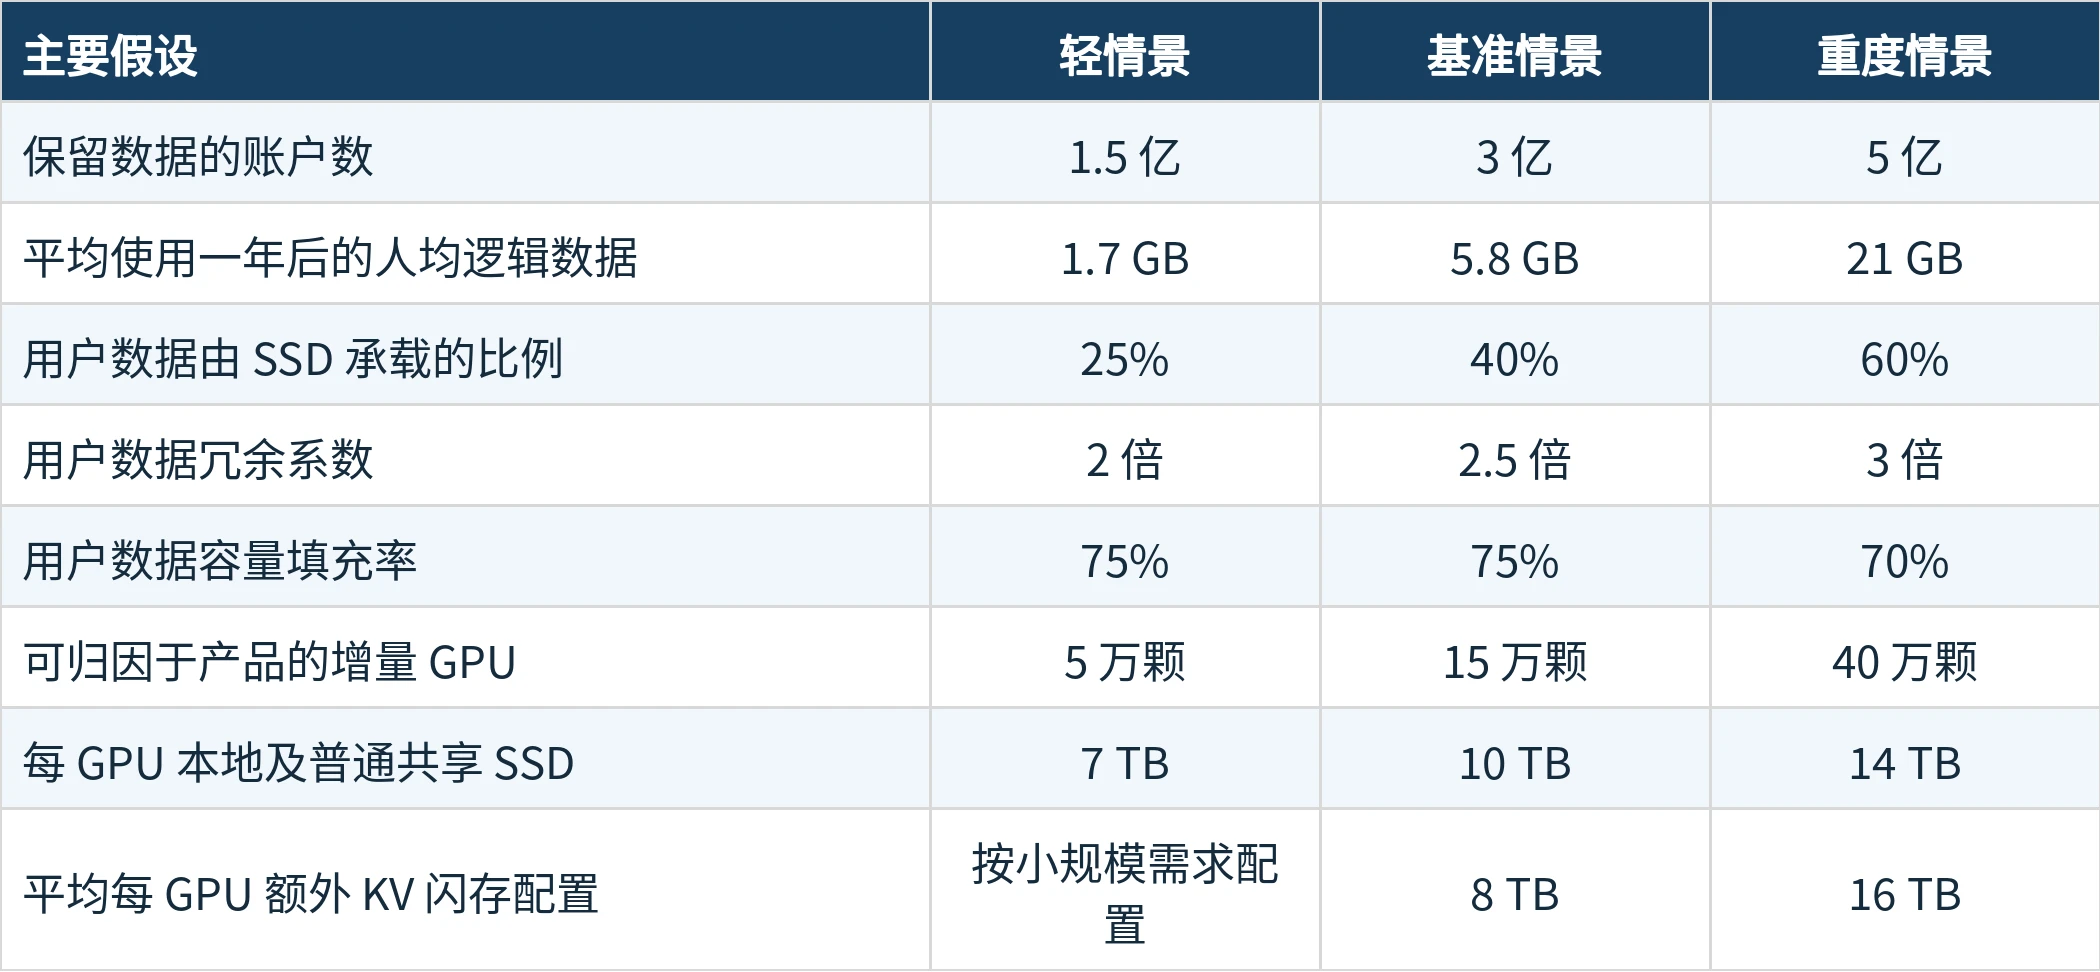
基准情景设定为:每个账户初始保存 1 GB,此后每月净增加 0.4 GB,平均使用一年后,实际数据存量为 5.8 GB。
如果有 3 亿个仍保留数据的账户,总逻辑数据量就是 1.74 EB。
接下来需要判断其中多少落在 NAND 上。云端存储同时可以使用 HDD 和 SSD。谷歌的 Colossus 存储系统就采用两类介质,并通过缓存和数据放置机制,将适合的数据放到 SSD 上。
因此,笔者假设其中 40%由 SSD 承载,再考虑 2.5 倍冗余和 75%的容量填充率,得到:
3 亿账户 × 5.8 GB × 40% × 2.5 ÷ 75% ≈ 2.32 EB。
这里的每月净增量,已经扣除了临时文件清理和重复内容。代理读取 Gmail 或 Google Drive 中的资料,也可能只保存引用、摘要和索引,无需重新复制整个文件库。
另一方面,代理如果频繁检索和修改历史资料,就可能提高 SSD 承载比例。对 NAND 而言,数据总量增加和闪存占比提升,都能带来需求。
四、工作存储和 KV 缓存,跟着任务规模扩张
集群工作存储可以从硬件配置入手。
NVIDIA DGX B200 配备 8 颗 GPU,以及合计 30.72 TB 的本地数据缓存 SSD,折合约 3.84 TB/GPU。笔者将其取整为 4 TB,作为本地存储参考,再根据不同情景加入普通共享存储。
基准情景假设有 15 万颗增量 GPU 服务于 Muse,每颗对应 4 TB 本地 SSD、6 TB 普通共享 SSD,合计约 1.5 EB。加上沙盒工作盘,这部分约为 1.57 EB。
这些容量随集群扩张增加。已有资源池能够承接更多任务时,采购增长可以慢于任务增长;资源池接近容量或性能上限后,就需要扩容。
KV 闪存层则承担另一项功能:保存值得复用的推理上下文,减少重复计算。
NVIDIA 对 CMX 的定义是面向可复用 KV 缓存的共享闪存层。这类数据可以重建,存储系统因此可以采用不同于长期用户文件的保留和保护方式。
笔者在基准情景中,假设平均每颗 GPU 额外配置 8 TB KV 闪存,15 万颗 GPU 对应 1.2 EB。
同一份 KV 如果已经放在这层闪存里,就不再额外计算一遍“每用户 KV 容量”。用户侧上下文估算可以用于检查硬件容量是否充足,最终采购按物理配置计算。
五、单个 Muse:基准约 5 EB,重度约 40 EB
按照上述框架,设置轻、基准和重度三个情景。参数均为笔者假设,用于判断量级。
表 2 单个平台的三种情景假设
资料来源:笔者假设与测算;本地 SSD 配置参考 NVIDIA DGX B200。
计算结果如下:
表 3 单个平台配置存量与行业规模比较
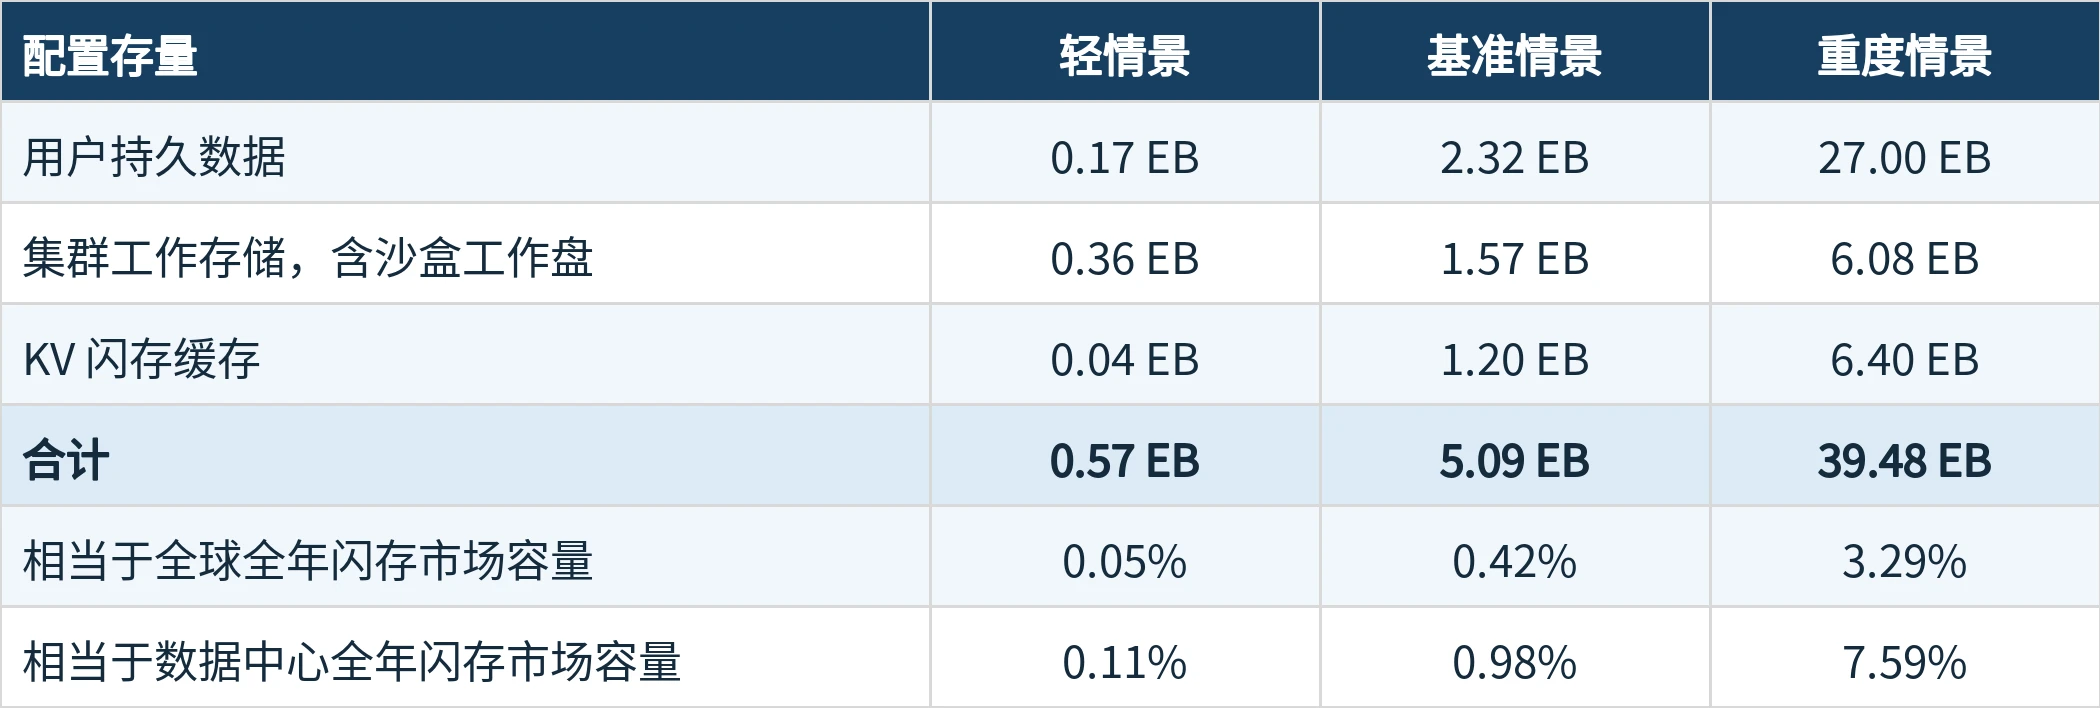
注:笔者测算。行业分母参考铠侠 2026 年投资者日第 15 页,按图中柱高估算,2026 年全球约 1,200 EB、数据中心约 520 EB;配置按 SSD 标称容量粗算,未单独调整盘内预留空间。
单个 Muse 的基准需求,在全球 NAND 市场中占比仍然较小。
重度情景明显放大,主要来自用户持久数据:更多账户、更高人均数据量和更高闪存占比同时发生。这是产品深度使用后的情景,不能只靠注册用户增长来实现。
表中计算的是配置存量。它如果在一年内全部新建,才接近相应的当年采购规模;如果分几年建设,当年需求要看实际扩容量。
六、从 Muse 走向十亿个人代理用户
笔者认为,个人代理大概率会成为多个平台共同竞争的产品类别。Google、Apple、OpenAI 等厂商都有动力,让 AI 从回答问题进一步走向替用户持续做事。
因此,对 NAND 的研究应当逐渐从一个 Muse,扩展到整个个人代理行业。
先考虑十亿个仍保留数据的代理账户。保持前述基准情景的人均存储、活跃账户比例和工作强度不变,整体规模相当于 3 亿账户基准的约 3.33 倍:
表 4 十亿代理账户的行业情景
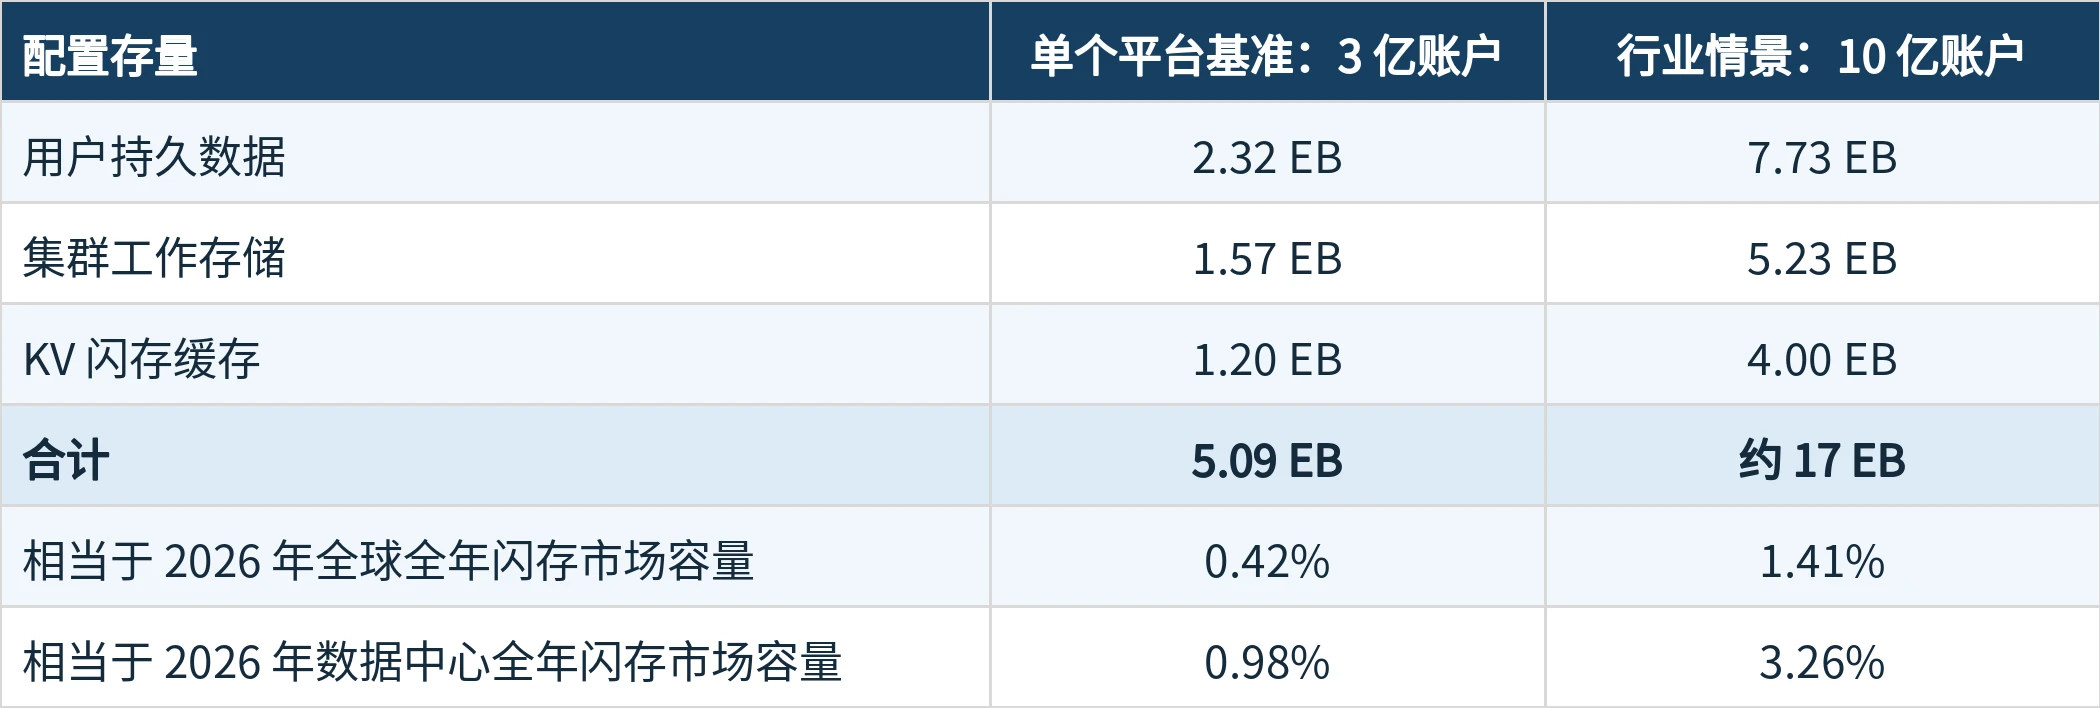
注:十亿账户是行业规模情景,不代表十亿日活,也不对应某个确定年份。同一个人在多个平台使用代理时,应根据实际保存的数据和执行的任务计算,不能简单将各平台用户数视为独立自然人。
这个量级已经比单个产品更值得关注,但十亿用户本身仍不足以支撑特别激进的 NAND 需求判断。用户是否持续使用,以及把多少工作交给代理,同样重要。
以十亿账户为例,如果全部按基准速度每月净增加 0.4 GB 数据,保持闪存比例和冗余不变,仅用户持久数据就对应每年约 6.4 EB 的新增 SSD 容量。如果只有部分账户持续积累数据,则按相应比例缩减。
如果任务更长、并行代理更多,集群工作存储和 KV 闪存池还会进一步扩张。尤其是每 GPU 闪存配置提升,可能在用户增长之外形成另一条需求来源。
这两条增长路径需要分别跟踪:用户留下的数据在积累,推理系统为了提高运行效率,也可能配置更多闪存。
七、NAND 的增量,要看整类产品如何被使用
个人代理为 NAND 增加了新的需求来源。用户数据可以长期积累,代理执行任务需要工作存储,长上下文推理又会提高缓存复用的价值。
但从目前的量级测算看,单个 Muse 的基准需求还不足以明显改变全球 NAND 的供需判断。更值得关注的是,个人代理是否成为覆盖十亿用户的日常产品,以及使用强度能否持续提升。
后续可以重点观察三个窗口:
- 人均实际存储:使用一个月、半年和一年后,每个账户净留下多少数据,其中多少需要 SSD 承载。
- 代理工作强度:日活账户占比、每日任务数和并行任务数是否持续上升,是否推动执行与推理集群扩容。
- 实际闪存配置:每颗 GPU 配套多少本地与共享 SSD,KV 闪存层的采用比例和容量是否提高。
对 NAND 的投资判断,最终要落到新增采购。现有集群扩容、旧盘替换和已有需求迁移,需要分别处理;行业预测中已经包含的 AI 增长,也不能再完整加上一遍。
笔者更看重的变化是:个人代理可能同时扩大需要保存的数据量,以及需要频繁访问的数据量。随着 Google、Apple、OpenAI、Meta 等平台持续投入,这两项变化才有机会从单个应用的几个 EB,发展为整个行业更有分量的需求。
本文仅供研究交流,不构成投资建议。