2026.10.01 | AC | LLM | Meta & Gemini: Why Linear Extrapolation Fails
原标题:去年看空 Meta,今年说 Gemini 已死:线性外推为何反复出错?
摘要
市场容易把阶段性落后,外推成永久出局。 Meta和谷歌的新进展,正在挑战这种判断。前沿模型进入门槛很高,但大厂之间的领先优势未必牢固。 资金、算力、数据和工程积累,让落后者仍有持续追赶的条件。组织动荡不必然意味着能力衰退,也可能是修复的开始。 关键看调整后能否集中资源、提高执行效率、持续交付。谷歌的追赶能力还来自基础设施的持续改善。 训练与推理效率提升,为反复实验和规模化使用提供支撑。投资判断应关注持续纠错和交付能力。 一代模型的排名,不足以决定一家公司的长期竞争力。
去年,Meta模型落后、团队动荡,扎克伯格花重金招人也被质疑难以改变结局。今年,悲观叙事转向谷歌,甚至出现了重返最先进模型水平的概率已经降到零的判断。现在,Muse Spark、Muse以及刚发布的Gemini 4 Argon,正在让这些结论重新接受检验。
笔者认为,这两轮叙事暴露了同一个问题:市场很容易把一代模型的落后,外推成一家公司的永久失去竞争力;把组织调整中的混乱,外推成组织已经无法修复。前沿模型竞争的门槛很高,但对已经拥有资金、算力和人才基础的大厂,领先优势并没有牢固到足以轻易判定其他人出局。
先看今天:Meta已有修复证据,谷歌重回前沿竞争
4月8日,Meta发布Muse Spark。Artificial Analysis当时的独立评测将其列入前五,显示Meta重新具备参与前沿竞争的能力。当然,Spark在编码和部分智能体任务上仍有差距。对Meta更有意义的,是它用一代新模型证明了此前的落后可以被修复。
后续迭代也在继续。按Artificial Analysis当前相同版本的评测体系,Spark 1.3(max)的综合智能指数为48,Spark 1.2(xhigh)为40。两者推理配置有所不同,但新版本的进展说明,Meta的修复已经从首发模型延伸到持续交付。
进入9月,进展又从模型走向产品。Meta于9月8日推出个人AI智能体Muse,支持在独立应用和WhatsApp中处理任务。根据MarketWatch 9月26日的报道,Muse已连续约一周位居美国苹果App Store榜首。下载热度还需要留存和付费来验证,但这一开局已经表明:Meta的模型能力、产品设计和分发渠道,正在形成实际的产品竞争力。
谷歌的新信号来自9月30日发布的Gemini 4 Argon。Artificial Analysis的评测显示,其综合智能指数为53,与GPT-6 Astra(max)持平;自动化任务得分78%,高于Sonnet 5.5(max)的71%。终端任务得分57%,仍低于Astra的59%。谷歌此前最受质疑的智能体能力出现了明显改善,尽管优势尚未覆盖所有任务。
价格也让这次回归更有分量。Argon优惠期输入和输出报价分别为每百万tokens 2美元、10美元,标准价为4美元、20美元。谷歌重新进入前沿竞争的同时,也在争取客户的实际使用。
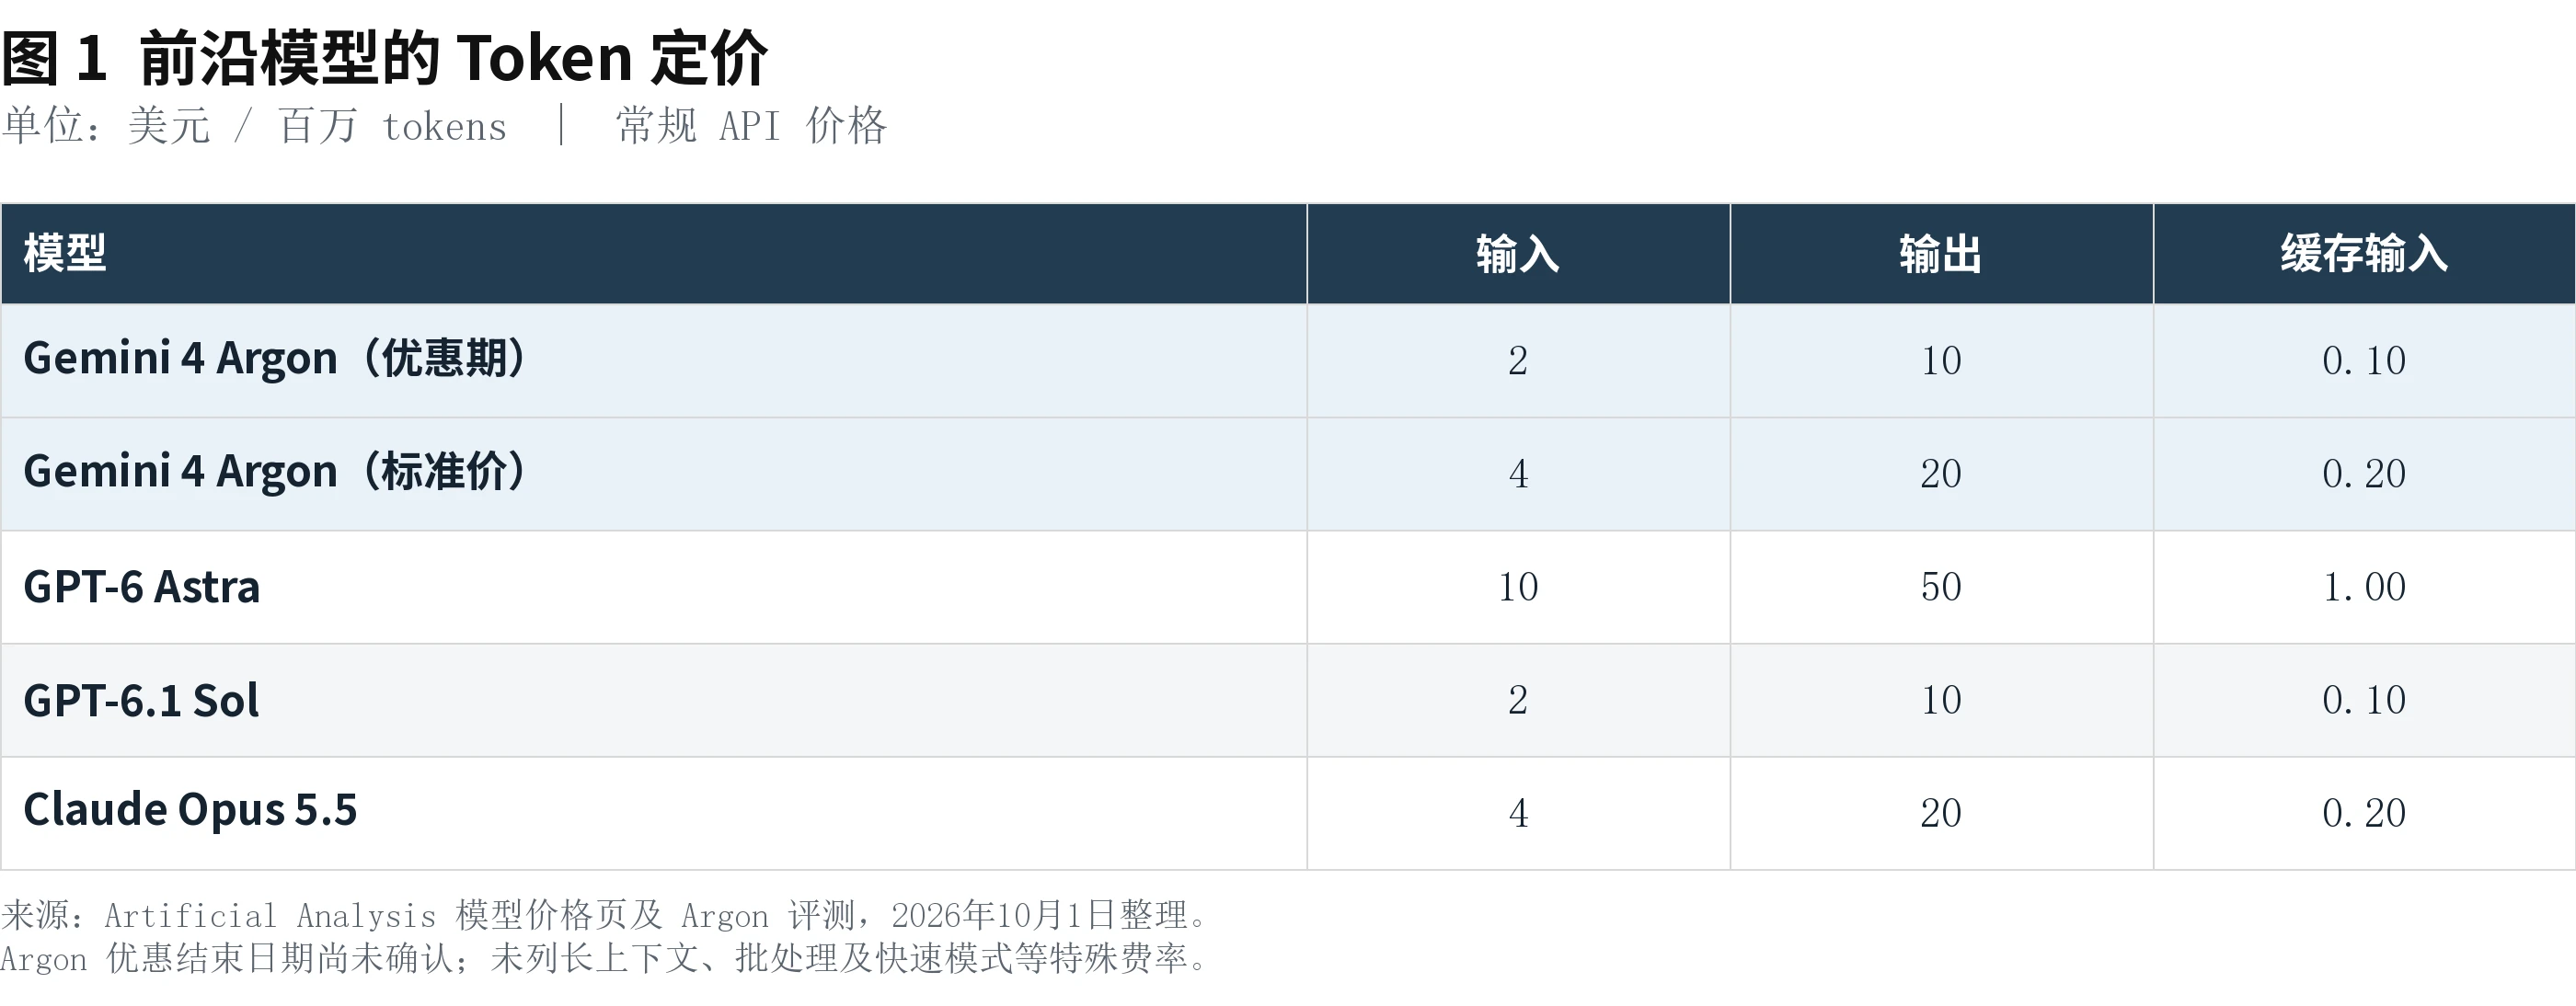
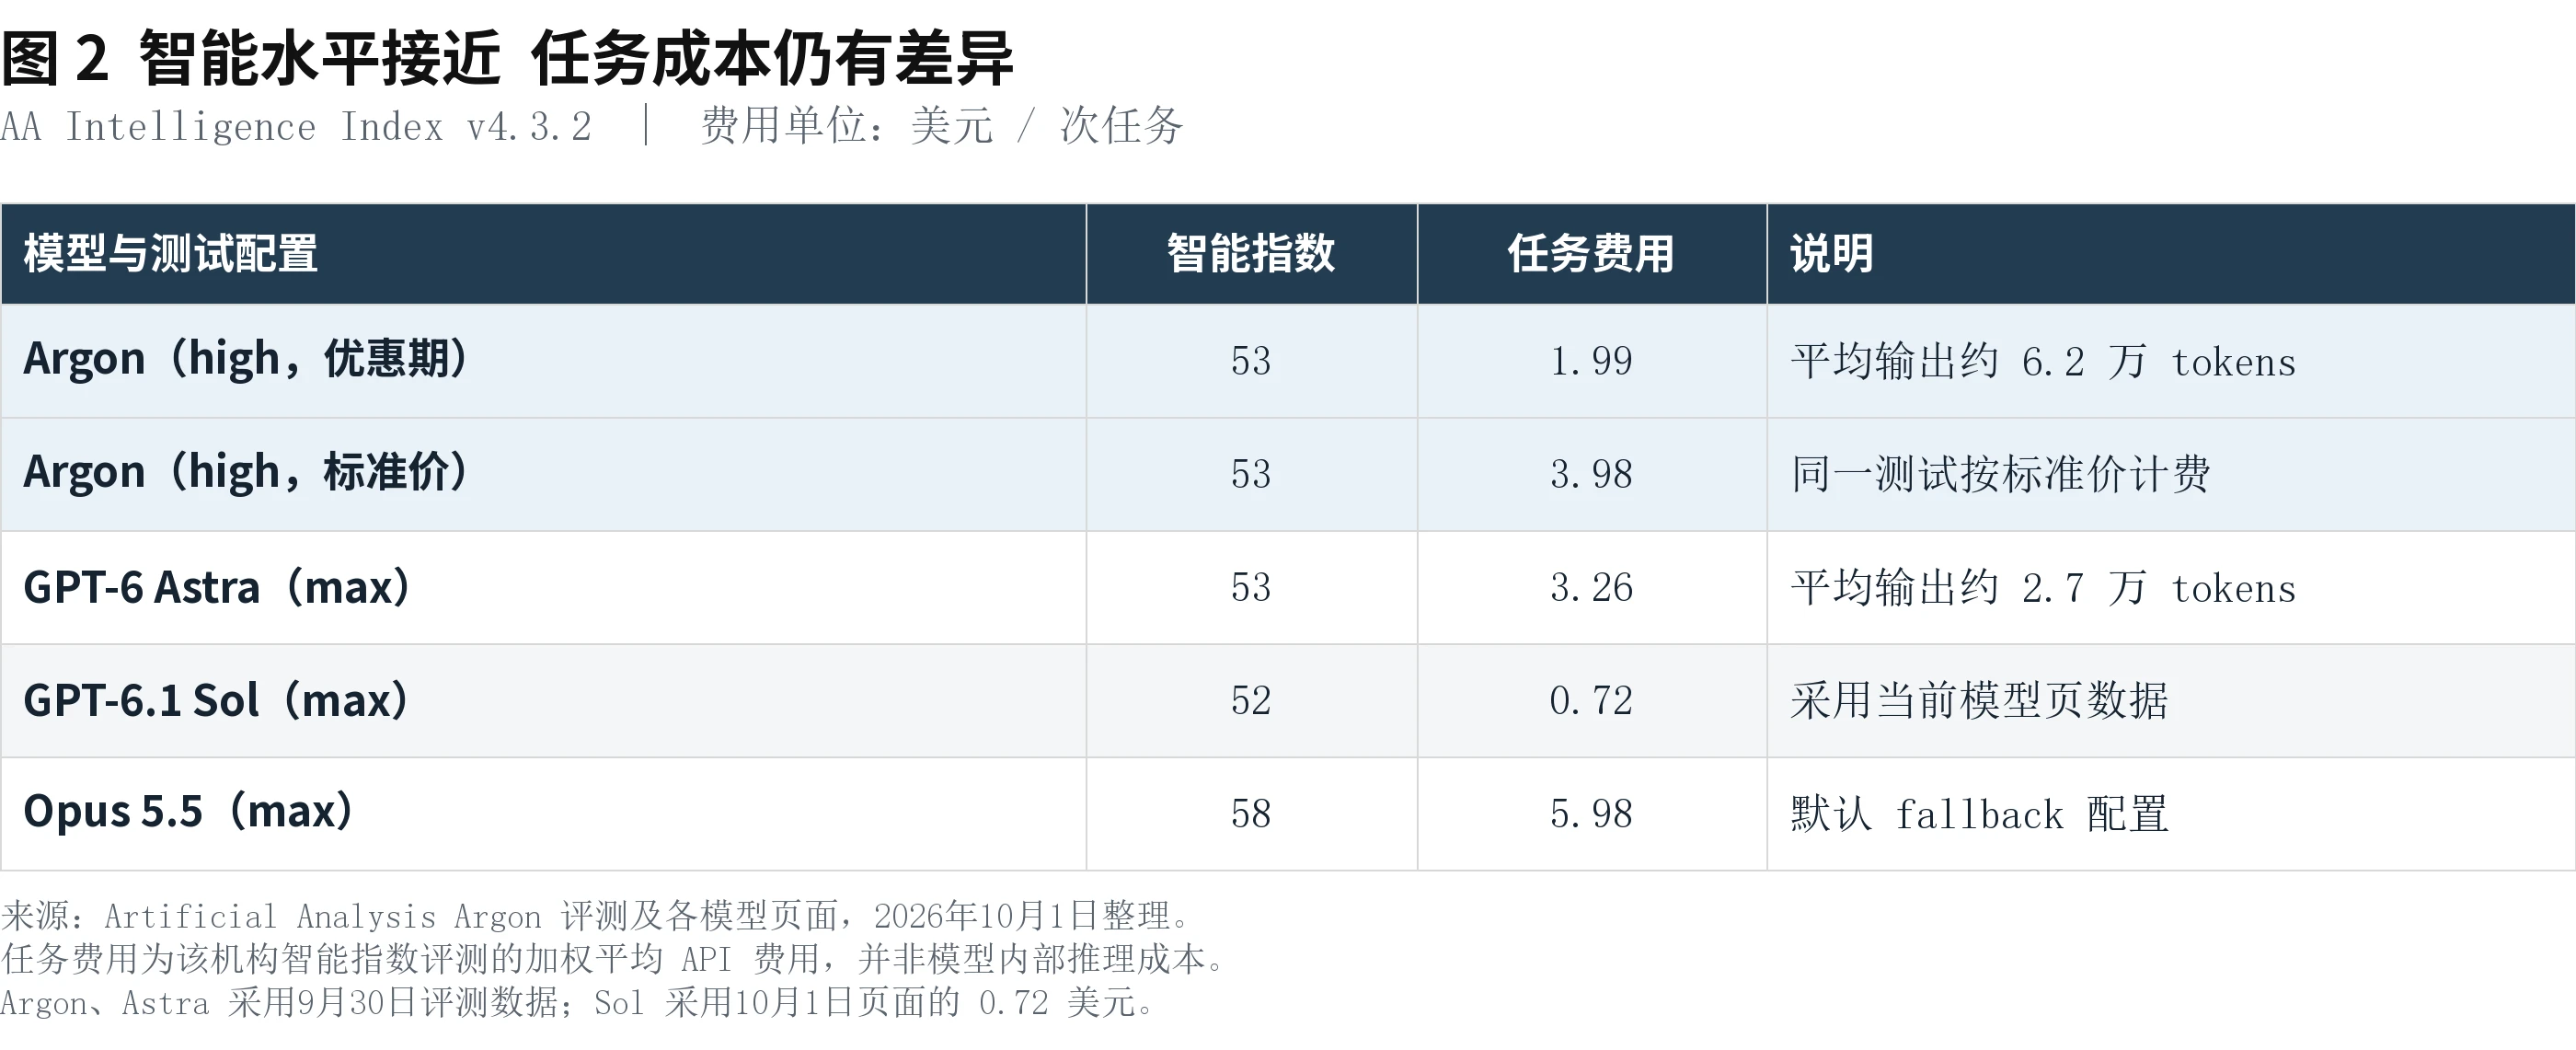
不过,token报价不能直接等同于完成任务的费用。Argon在该项评测中平均输出约6.2万tokens,Astra约2.7万;前者优惠期任务费用较低,恢复标准价后则高于Astra。这些数据支持谷歌重新具备竞争力,也提醒我们,模型表现、输出效率和定价需要一起看。
Argon目前仍面向部分用户开放,公开使用表现和持续迭代还需要观察。现有证据已经足以说明,谷歌重新进入了前沿竞争。当然,把它概括为全面翻盘还早。
回到当时:悲观判断如何一步步走向出局结论
Meta在2025年面对的质疑,首先来自研究圈。4月7日,模型研究员Nathan Lambert在Interconnects评论Llama 4时,直接问Meta是否按下了恐慌按钮。他认为,Llama已失去开源标准的地位,而在持续的组织问题之下,要夺回这一位置十分艰难。
随后,扎克伯格大规模挖人、重建AI团队,组织能否磨合成为新的焦点。WIRED在当年8月报道,新超级智能实验室成立仅约两个月,已有至少三名研究员离开,其中两人在Meta停留不足一个月后回到OpenAI。
在6月30日新实验室宣布成立时,Bindu Reddy就在X上判断,Meta看起来落后最先进模型约一年,并写道:
“Even a multi-billion reorg may not save them”
即使投入数十亿美元重组,也未必能救得了它。
更有分量的质疑来自图灵奖得主、Meta前首席AI科学家Yann LeCun。2025年11月,他宣布将离职创业;2026年1月2日刊出的《金融时报》访谈中,他称新任AI负责人Alexandr Wang缺乏研究管理经验,并预言:
“A lot of people have left, a lot of people who haven’t yet left will leave.”
很多人已经离开,很多尚未离开的人也会离开。
从外部研究者对Llama的失望,到前首席科学家对新管理层的质疑,Meta当时面对的悲观叙事已经超出一代模型表现:旧团队失去信任,新负责人能否带领研究员,重金招来的人又能否留下,都受到怀疑。
这些材料说明,当时对Meta的质疑确实深入到了组织和人才层面。Spark和Muse所证明的,是Meta仍能重建模型与产品竞争力;把上述问题进一步推导成公司已经失去修复能力,才是笔者要讨论的外推。
到了2026年8月7日,SemiAnalysis对谷歌的判断更为绝对。在《Gemini is Cooked but GCP is Cooking》中,它将人员流失、算力分配问题和组织文化联系起来,并写道:
“their odds of reaching SOTA again have dropped to zero.”
谷歌再次达到最先进模型水平的概率,已经降到零。
这就是“Gemini已死”最值得讨论的地方。对当期差距、人才流失和组织效率的担忧,可以是准确的;从这些事实推导出未来追赶概率为零,却是一个强得多的结论。Argon的出现,首先冲击的就是这种永久退出前沿竞争的判断。
真正被低估的,是把组织和工程重新做对的能力
这一轮模型竞争,当然存在很难的研究问题,也依赖优秀的技术判断。但能够把一代模型做出来、稳定提升并交付给用户,包含大量可以拆解、验证和反复改进的工作:数据质量、实验设计、训练稳定性、评测体系,以及研究结果能否顺利进入产品。
姚顺宇在张小珺2026年5月发布的访谈中,对这件事讲得很直接:“AI个人英雄主义时代已经过去了”。他强调可靠、细致和对工作负责,也谈到Anthropic明确决策、迅速推进的执行方式。
这段访谈的启发是,前沿模型能力要通过一整套组织系统生产出来。顶尖研究员很重要,但人才名单本身解释不了全部结果。技术方向由谁决定,决定之后资源能不能集中,实验出了问题谁负责,以及团队能否快速知道自己哪里做错了,这些同样决定模型最终表现。
这也解释了为什么一家大厂落后以后,仍然可能追回来。资金和算力给它持续试错的条件,人才市场给它重新组队的机会,而清晰的目标和责任机制,才把这些投入转化成有效进展。追赶所需要的,往往包括把已经知道重要的事情认真做好,把训练、评测和交付中的问题逐一解决。
Meta的变化提供了一个具体例子。公司在Spark发布时披露,团队用了约九个月重建底层技术体系,涉及模型架构、优化方法和数据。虽然这是公司的自述,但独立评测提供了结果端的验证。把这段过程全部解释为花钱挖人,遗漏了新团队到位之后真正发生的工程重建。
市场线性外推最容易漏掉的,恰恰是公司的反应。模型落后,会促使管理层换人、改目标、调整算力分配、重建技术路线。失败本身会推动组织改变。用旧组织的表现,预测改变后的组织必然继续失败,相当于假设管理层面对危机什么也不会做。
人员离开,也可能是组织修复的一部分
谷歌的争论尤其典型。很多观察首先关注的是名气最大的研究者是否离开,然后据此判断公司的技术能力还剩多少。这个方法直观,却容易把历史贡献和当前职责混在一起。
笔者的渠道调研显示,部分资深研究者如Jeff Dean虽然对Google AI有重大历史贡献,但过去一两年已经逐渐远离Gemini前沿模型的日常执行;管理职责进一步集中,可能有利于后续推进。随着Koray Kavukcuoglu承担日常经营和执行职责,新的组织安排更值得观察的是决策和资源能否围绕下一代模型集中。
对于Jeff Dean等人的离开,应该追问的是:他们当时具体负责什么,原来的职责由谁接手,关键项目有没有因此停摆,新的技术负责人是否拥有足够的决策权。把新闻里的名字逐一减掉,就得出组织能力必然等比例下降,过于简单。
优秀科学家对长期基础研究、AI for Science或创业产生兴趣,完全可以理解。一个追求长期科学突破的组织,和一个必须在明确时间内交付下一代模型的团队,目标和工作方式会有所不同。对企业而言,让负责人、资源配置和当前目标重新匹配,可能比保留所有知名人物更重要。
因此,人员流失既可能暴露问题,也可能伴随修复。判断依据应当落到调整后能否稳定交付、实验效率是否改善、关键岗位是否补齐。离开本身无法自动给出答案。
谷歌的基础设施能力也在改善。公司在2025年第四季度业绩说明中披露,通过模型优化、效率和利用率提升,2025年Gemini单位服务成本下降了78%。2026年4月发布的第八代TPU,又分别针对训练和推理优化,并改进网络与数据传输。
笔者认为,这些积累使大厂有条件持续追赶。训练集群、网络、软件和部署经验不会随着一代模型失利而消失;基础设施效率提高,同样的预算就有机会支持更多实验和更大规模的使用。组织调整决定资源如何投入,工程体系决定投入能否有效执行,两者共同影响下一代模型。一次延期或失败,并不足以把这套能力归零。
进入门槛很高,不代表领先位置不可挑战
回到最初的问题:前沿模型的壁垒到底深不深?笔者认为,需要区分进入这个行业的门槛,以及已经进入的几家大厂之间,领先优势能维持多久。前者很高,后者仍然存在很大的竞争空间。
对普通公司而言,凑齐算力、资金、数据能力和成熟团队非常困难。但对Meta、谷歌这样的参与者,关键变量已经变成能否有效组织现有资源。它们不会因为一代模型失败,就失去所有基础设施、工程积累和招募能力。它们还有时间纠错,也有条件把成功方法扩大。
因此,笔者认同有资源的大厂始终有机会追赶,但不会把它进一步写成有钱就一定追得上。数据要转化成有效训练信号,算力要落实到正确实验,人才要在同一目标下协作。能把这些事情持续做对,本身就是稀缺能力。
Muse还提示了另一个容易被忽视的事实:公司不必等到模型在所有榜单上第一,才有机会做出受欢迎的产品。当能力跨过实用门槛,产品体验、场景和分发会开始影响结果。对拥有庞大用户渠道的公司,模型差距缩小之后,产品竞争力可能释放得比市场预想更快。
这对投资判断的影响很直接。一代模型领先,可以支撑当期的竞争优势,却不足以自动推导出长期垄断;一代模型落后,也不足以把一家资源充足、仍在认真修复的大厂价值归零。笔者更关注的是,公司能否连续交付更好的模型,能否把投入转化成真实使用,以及组织是否具备持续纠错的能力。
去年对Meta的悲观,今年对Gemini的悲观,未必错在发现了问题。真正容易出错的,是看到了问题以后,过早认定问题不会被解决。模型排名是一张不断更新的成绩单。一家公司的竞争力,还包括它拿到不及格成绩之后,能不能重新把事情做对。
#
本文基于公开资料及笔者个人研究整理,仅供交流参考,不构成任何投资建议