2026.10.07 | AC | Optical | CPU Revival & Optical Module Math
原标题:CPU回归的光模块账
摘要
- CPU回归经哪几道折算传导到光模块;
- 前端光模块的速率与用量各由什么决定;
- PCIe 6.0平台何时到位,前端800G何时放量;
- 前端增量来自何处,相对后端有多大;
- 收益先落在哪些环节,光模块厂拿到的是量还是价。
CPU回归只经前端网络拉动光模块,并经铜缆与收敛比两道折算。光模块速率看交换芯片,用量看PCIe 6.0带来的单机带宽。估算显示增量约为后端的4%到22%,先动的是AI集群前端。收益先落在网卡、Retimer与铜缆,光模块厂拿到的是销量。
Agentic AI让CPU重新成为数据中心采购的重点。英特尔在业绩会上表示,AI数据中心里CPU与GPU的配比已由1:8变为1:4,并会走向对等。英伟达也把Vera作为独立CPU推出,戴尔、HPE、联想与超微都将跟进独立的Vera服务器。市场由此推出光模块的第二波需求。然而CPU与光模块之间隔着一整张网络,CPU多出来的每一份需求,要经过几道折算才会变成光模块订单。
一、CPU服务器出了机柜才用光,第一跳仍由铜缆承接
CPU服务器接入网络的第一跳留在机柜之内,主要由铜缆承接。服务器网卡先连到机柜顶端交换机(ToR),这段连接在同一机柜里完成。IEEE 802.3ck为100G单通道无源铜缆设定的目标是至少2米,802.3dj在200G单通道把这一目标降到至少1.0米。这使得单口800G改走4×200G之后,无源铜缆能覆盖的距离明显缩短:机柜内较短的连接仍可用无源铜缆,距离一长就要换成有源铜缆(AEC),也就是在线缆两端加上信号处理芯片。博通称其800G网卡Thor Ultra的SerDes支持长距离无源铜缆,说明这条边界还会随芯片能力移动。但无论用哪一种,第一跳用的都是铜,不产生光模块需求。
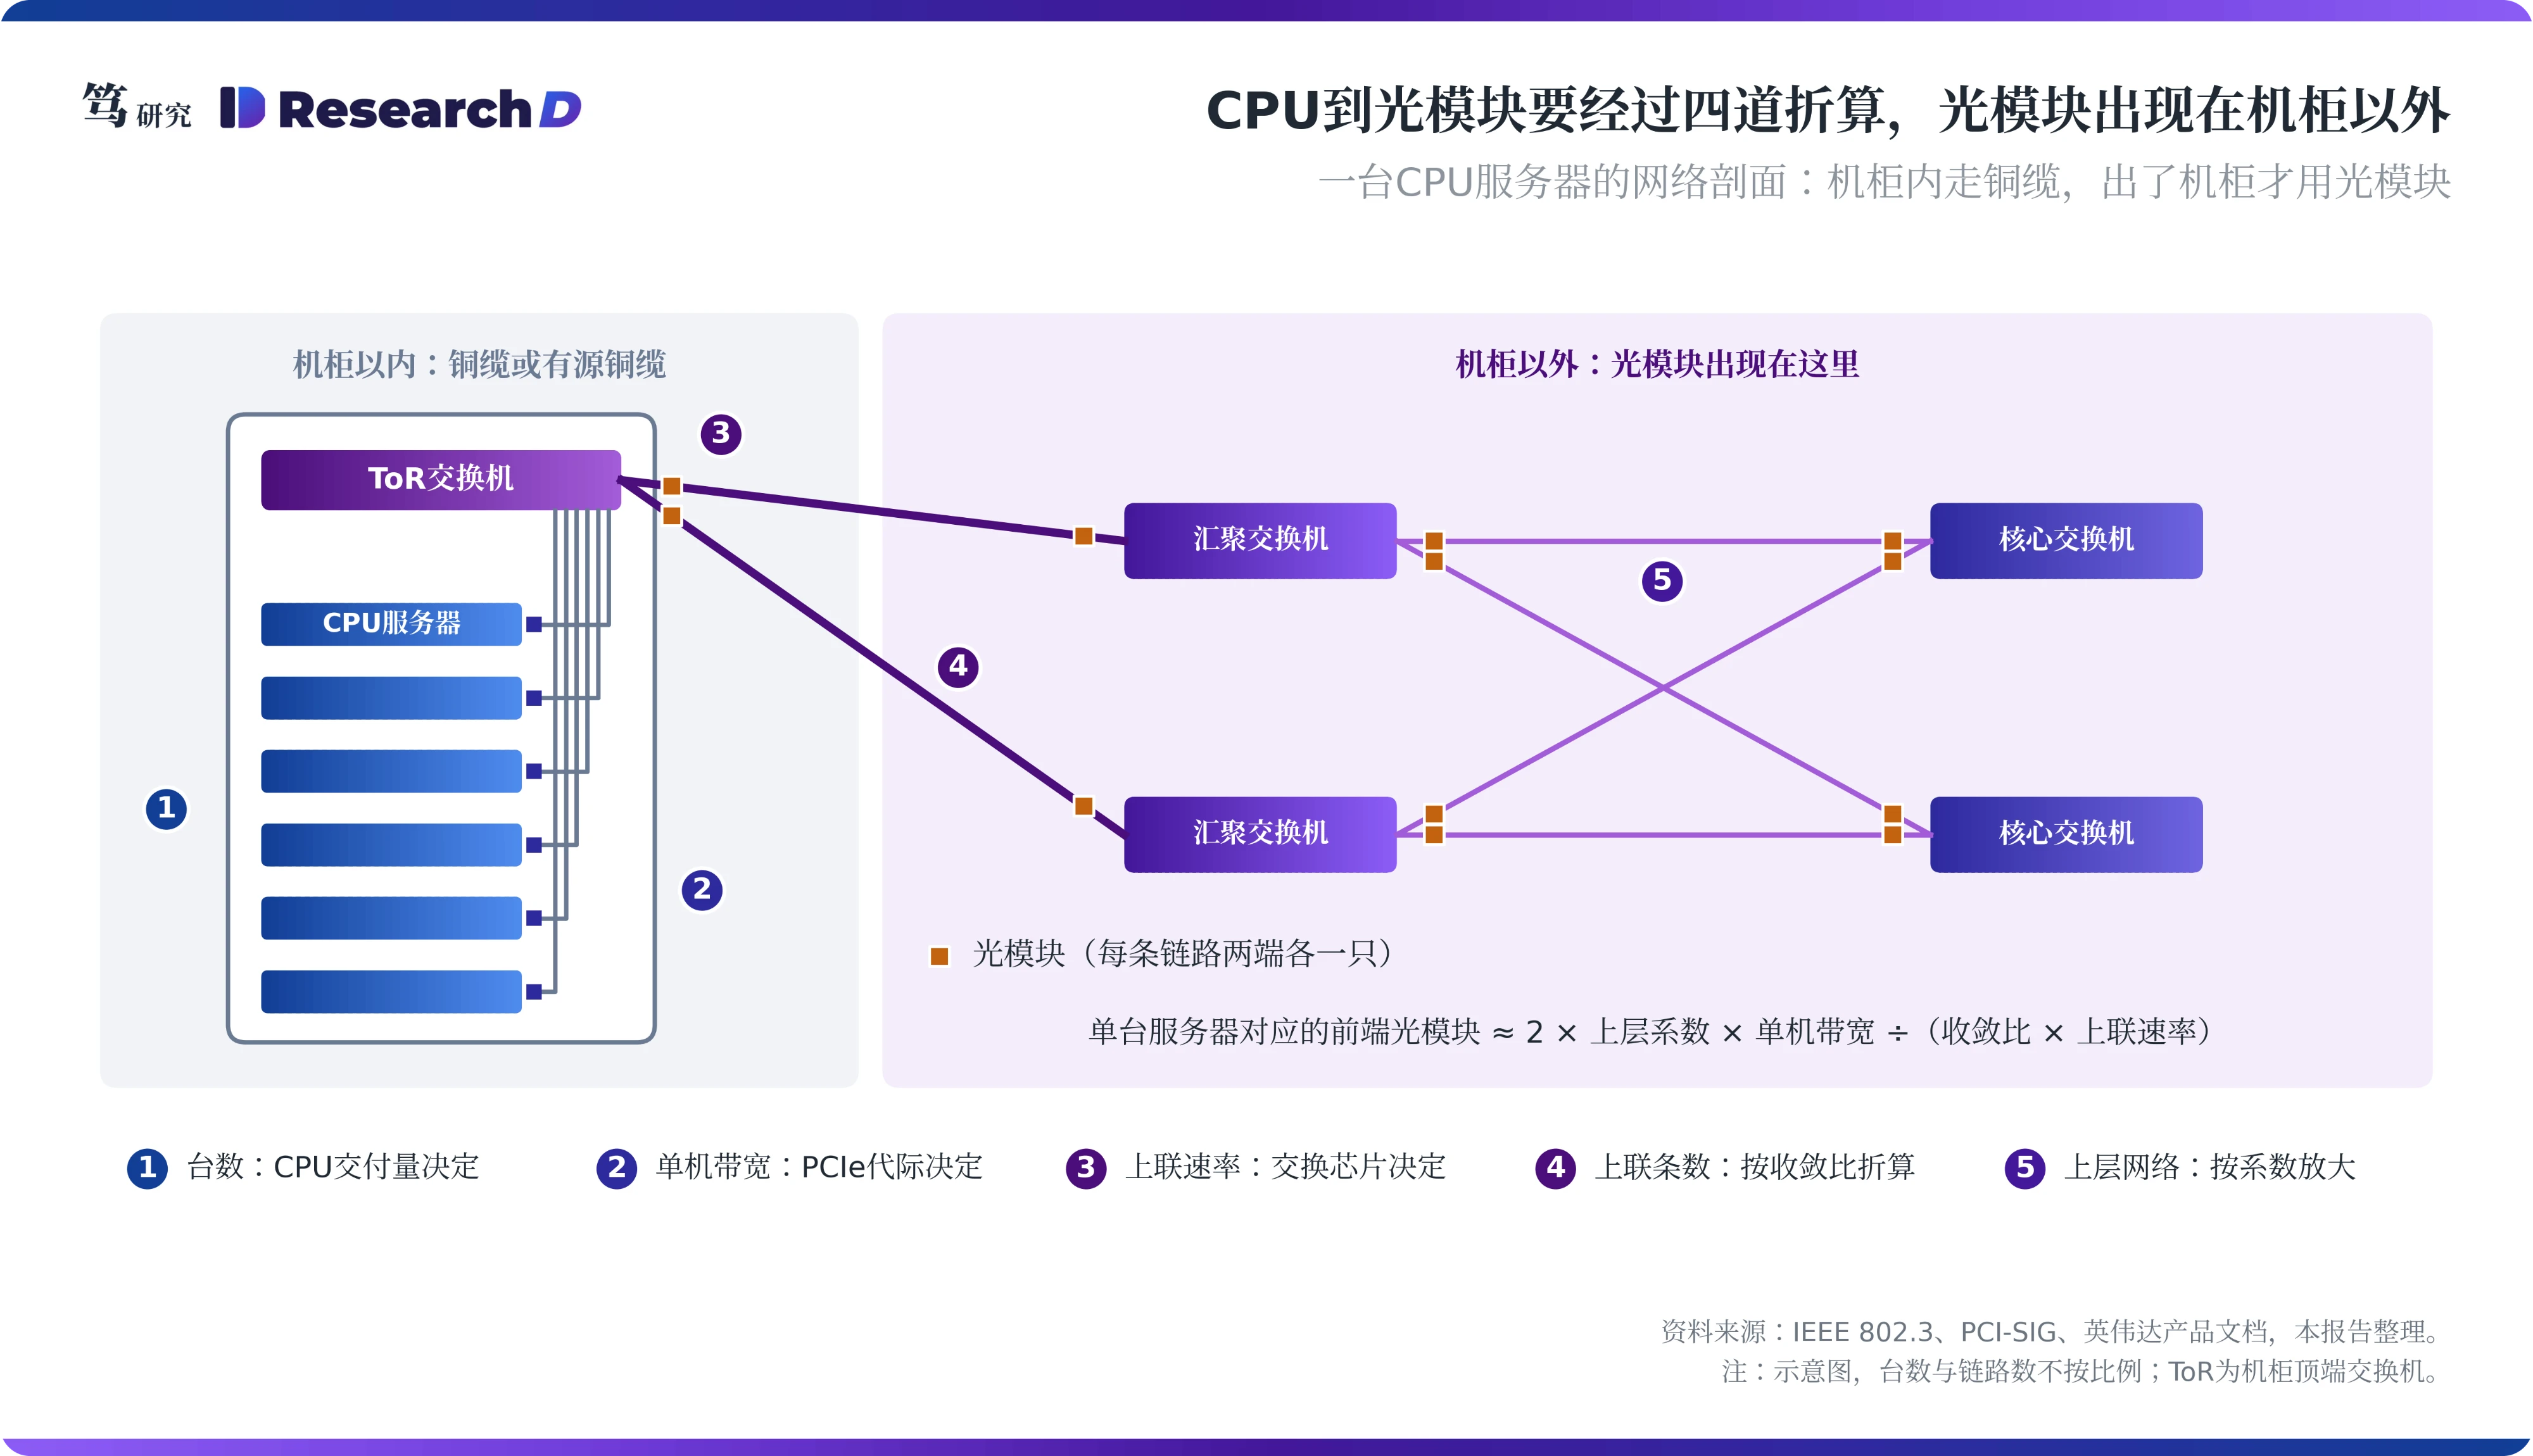
光模块从ToR的上联开始计数,而上联恰好是云厂最愿意节省的环节。收敛比是ToR下行带宽与上行带宽之比,3:1意味着三份下行只配一份上行。谷歌论文中写明,网络的主要成本在光模块与光纤,ToR上联是有意保持收敛、以节省成本的位置;按论文列出的配置计算,几代架构的ToR收敛比在2:1到5:1之间,早年的四柱架构下单机平均带宽只有100Mbps。Meta公开的F16架构则让每台ToR的上联与下行都是1.6T,即1:1。现代超大规模云前端的ToR收敛比多在1:1到3:1之间,常见测算里取的8:1缺少近年的公开依据。
这使得CPU对光模块的拉动要依次经过四道折算。服务器台数由CPU交付决定,单机带宽由网卡与PCIe代际决定,上联用什么速率由交换芯片决定,上联条数再按收敛比折算。四道折算里,速率与数量由不同环节决定。把两者分开,是判断前端800G节奏的第一步,也是回答CPU回归能否带来光模块第二波的起点。
二、光模块用多快看交换机,用多少看CPU平台
单个PCIe 5.0 x16插槽能满足400G网卡,800G网卡则需要PCIe 6.0。按PCI-SIG规格,x16链路的单向带宽在PCIe 5.0约为64GB/s,在PCIe 6.0约为128GB/s;400GbE线速约需50GB/s,800GbE约需100GB/s。所以800G网卡普遍采用PCIe 6.0接口,博通在2025年10月发布的Thor Ultra与英伟达的BlueField-4,主机接口都是PCIe 6.0 x16。
这一限制作用在单个插槽上,整机层面已有绕行办法。英伟达ConnectX-8可以把32条通道拆成两个x16,在PCIe 5.0服务器上以x32的方式提供800G连接。亚马逊云科技的C8gn实例基于PCIe 5.0的Graviton4与第六代Nitro卡,单实例网络带宽最高600Gbps。这说明依靠自研网卡的超大规模云已经绕开了插槽限制,笔者推测受这道限制约束的,主要是采购标准服务器的企业与二线云。
前端光模块的速率等级由ToR交换芯片决定。51.2T交换芯片以100G单通道组成800G端口,102.4T交换芯片以200G单通道组成1.6T端口。ToR上联插哪一档光模块,取决于这台交换机用的是哪一代芯片;服务器网卡的速率,影响的是上联的条数。Dell'Oro在2025年7月的五年预测中估计,前端网络将部署近9,000万个800G与1.6T交换端口,所用正是51.2T与102.4T两代芯片,后端的端口数则是前端的三倍以上。
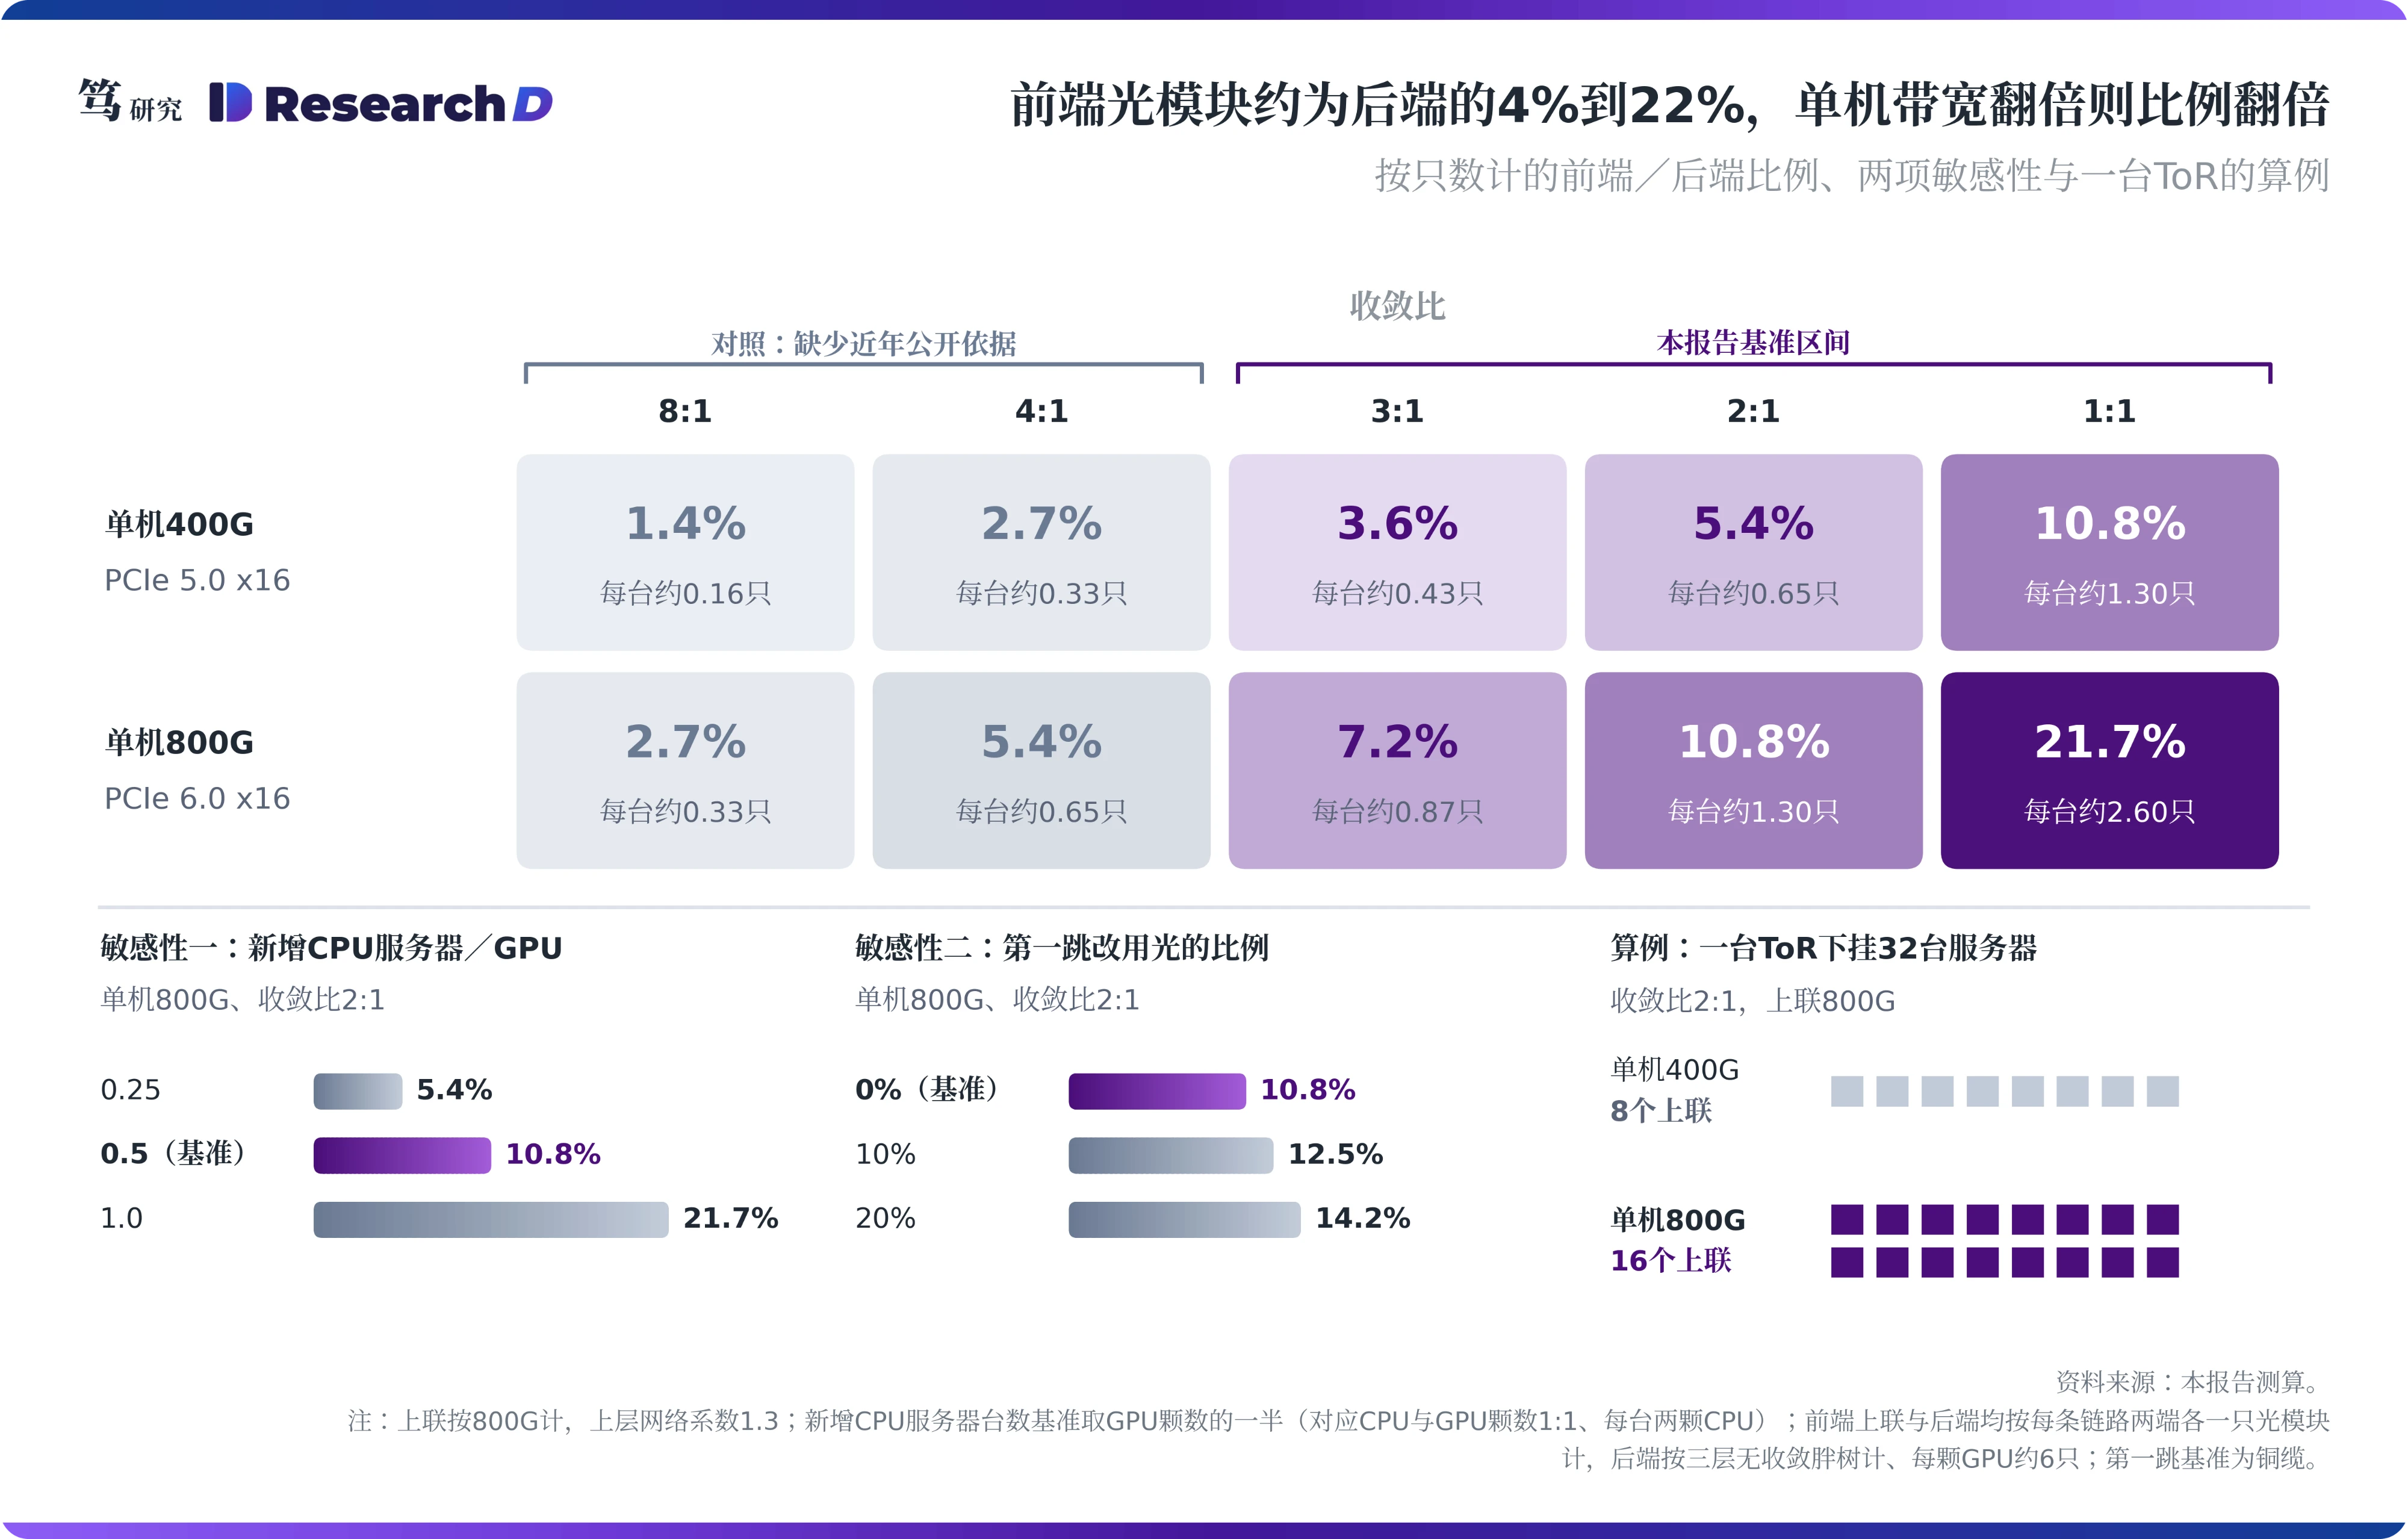
PCIe 6.0改变的是每台服务器的下行带宽,从而改变上联光模块的条数。收敛比与上联速率不变时,ToR需要的上联带宽与下挂服务器的总带宽成正比。单机带宽由400G升到800G,上联光模块的条数随之翻倍。以一台下挂32台服务器的ToR为例,粗略计算,收敛比2:1时单机400G对应8个800G上联,单机800G则对应16个。换言之,PCIe 6.0决定的是前端光模块用多少,平台换代的节奏也就决定了这部分增量何时出现。
三、新一代CPU平台已陆续上市,通用服务器换代集中在2027年
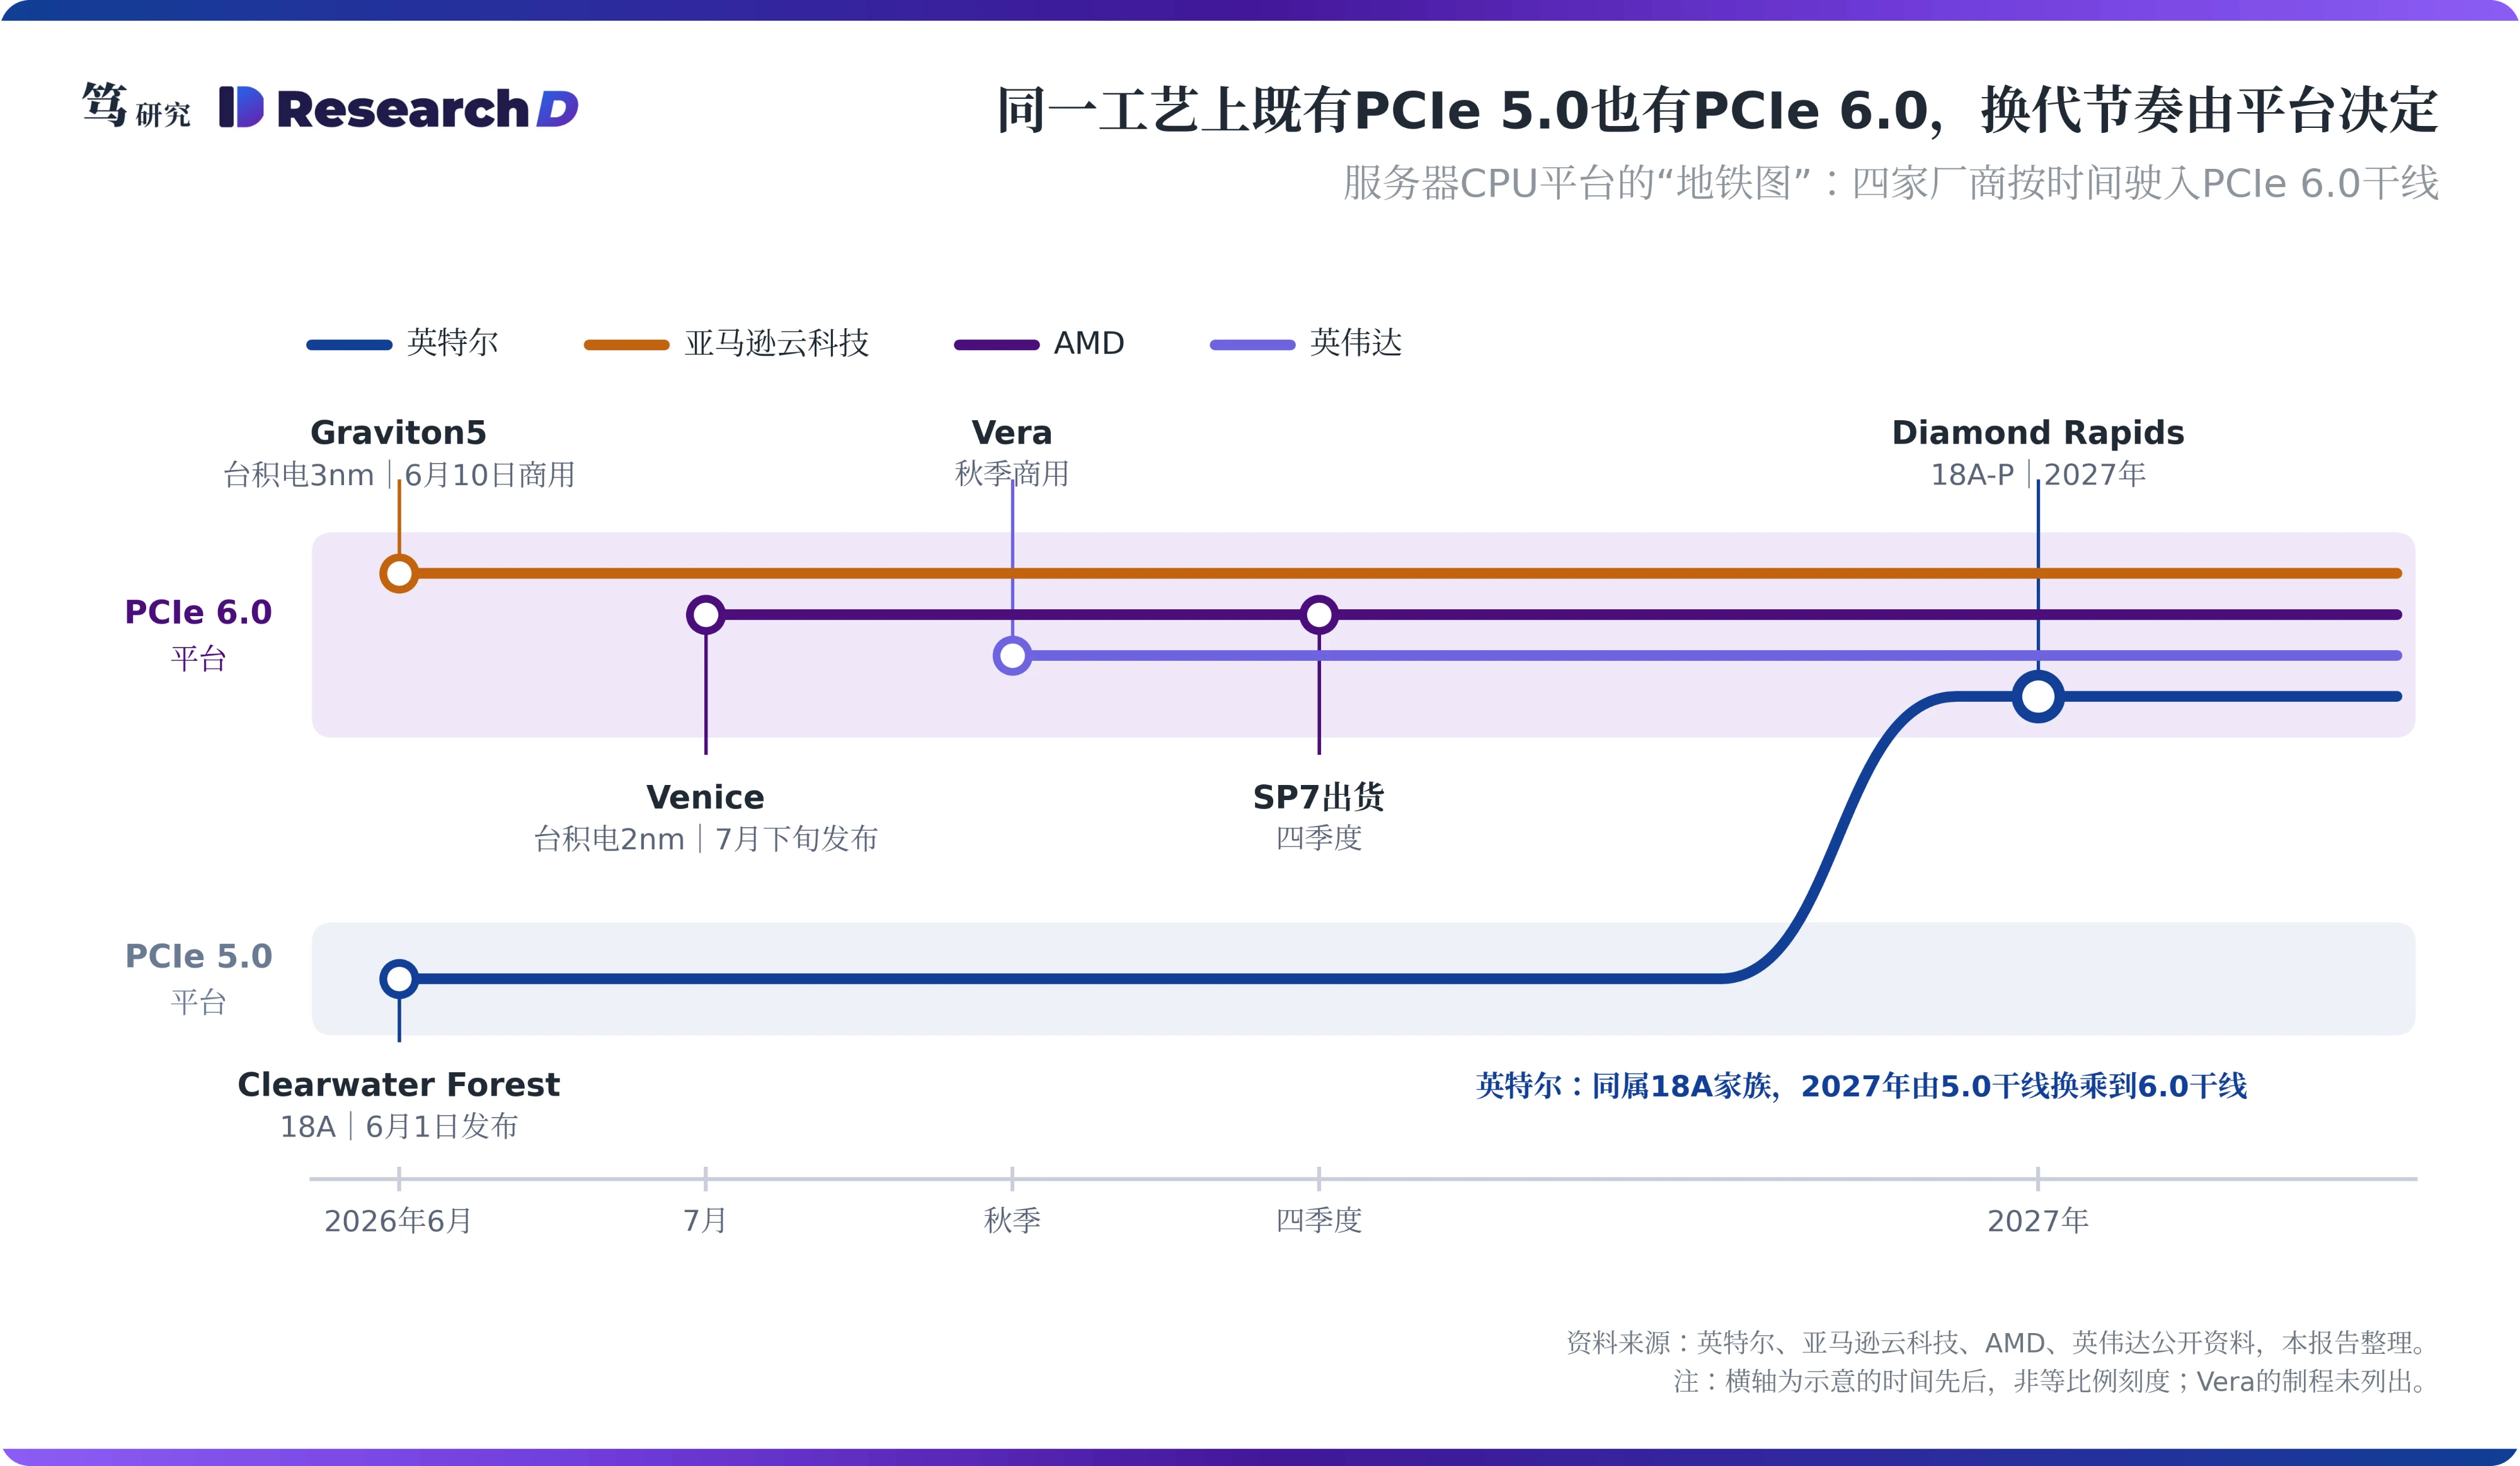
PCIe 6.0随CPU平台的设计代际到来,同一工艺节点上两代接口并存。英特尔基于18A的Xeon 6+(Clearwater Forest)于2026年6月1日发布,最多288个能效核,I/O仍是96条PCIe 5.0。同属18A家族的Diamond Rapids(18A-P)才引入PCIe 6.0,英特尔在Computex 2026把推出时间定在2027年,并在8月的Hot Chips 2026上披露其最多256个性能核、128条PCIe 6.0。亚马逊云科技基于台积电3nm的Graviton5在6月10日正式商用,提供96条PCIe 6.0;AMD基于台积电2nm的Venice在7月下旬发布,首批SP7产品四季度出货;英伟达Vera同样支持PCIe 6.0,2026年秋季商用。这说明PCIe 6.0的到来要按平台逐家看,工艺节点只能作为旁证。
通用服务器的主力换代仍落在2027年。笔者9月16日报告认为,PCIe 6.x Retimer与MRDIMM受同一代服务器平台约束,增量对应2027年的平台换代,这一时点同样适用于前端网络。但平台到位只是抬高了单机带宽的上限,落到上联数量,还要等网卡与ToR一起更换。Graviton5的M9g实例在各规格上的网络带宽平均最多提高约15%,最大规格由M8g的50Gbps提高一倍,可见云厂换平台时对带宽的上调是渐进的。
据此本文预计,通用CPU前端的800G放量落在2027年下半年到2028年。节奏由网卡与ToR的更换周期决定,前提是云厂愿意为Agent负载上调单机带宽。在此之前,前端网络的800G需求另有来源,这也决定了CPU回归在光模块需求里的分量。
四、前端需求先来自AI集群,CPU新增中只有约两成新增网络端口
前端网络的新增需求过半来自AI相关部署。Dell'Oro在2026年8月发布的前端网络五年预测中估计,未来几年前端数据中心交换机销售增长的一半以上由AI相关机会驱动,AI相关的前端建设将率先采用800G与1.6T。预测指出,部分部署里XPU与CPU的配比正由10:1向1:1靠拢,CPU承担编排与数据搬运,KV cache存储机架也需要新的网络连接。该机构在2025年7月就判断,过去几年通用服务器的前端交换机销售主要来自存量升级,扩容明显放缓;新的连接需求来自把加速服务器接入前端做数据摄入,这类连接要求高速,并带有价格溢价。英伟达的独立Vera机柜最多装256颗CPU,配BlueField-4与ConnectX-9,可同时运行超过2.25万个沙箱环境,本文推测Agent沙箱以密度取胜、单个沙箱占用的带宽有限。英伟达把BlueField-4定位于AI集群的南北向前端,这部分带宽由支持PCIe 6.0的Vera与GPU平台供数,时间上先于通用x86服务器。
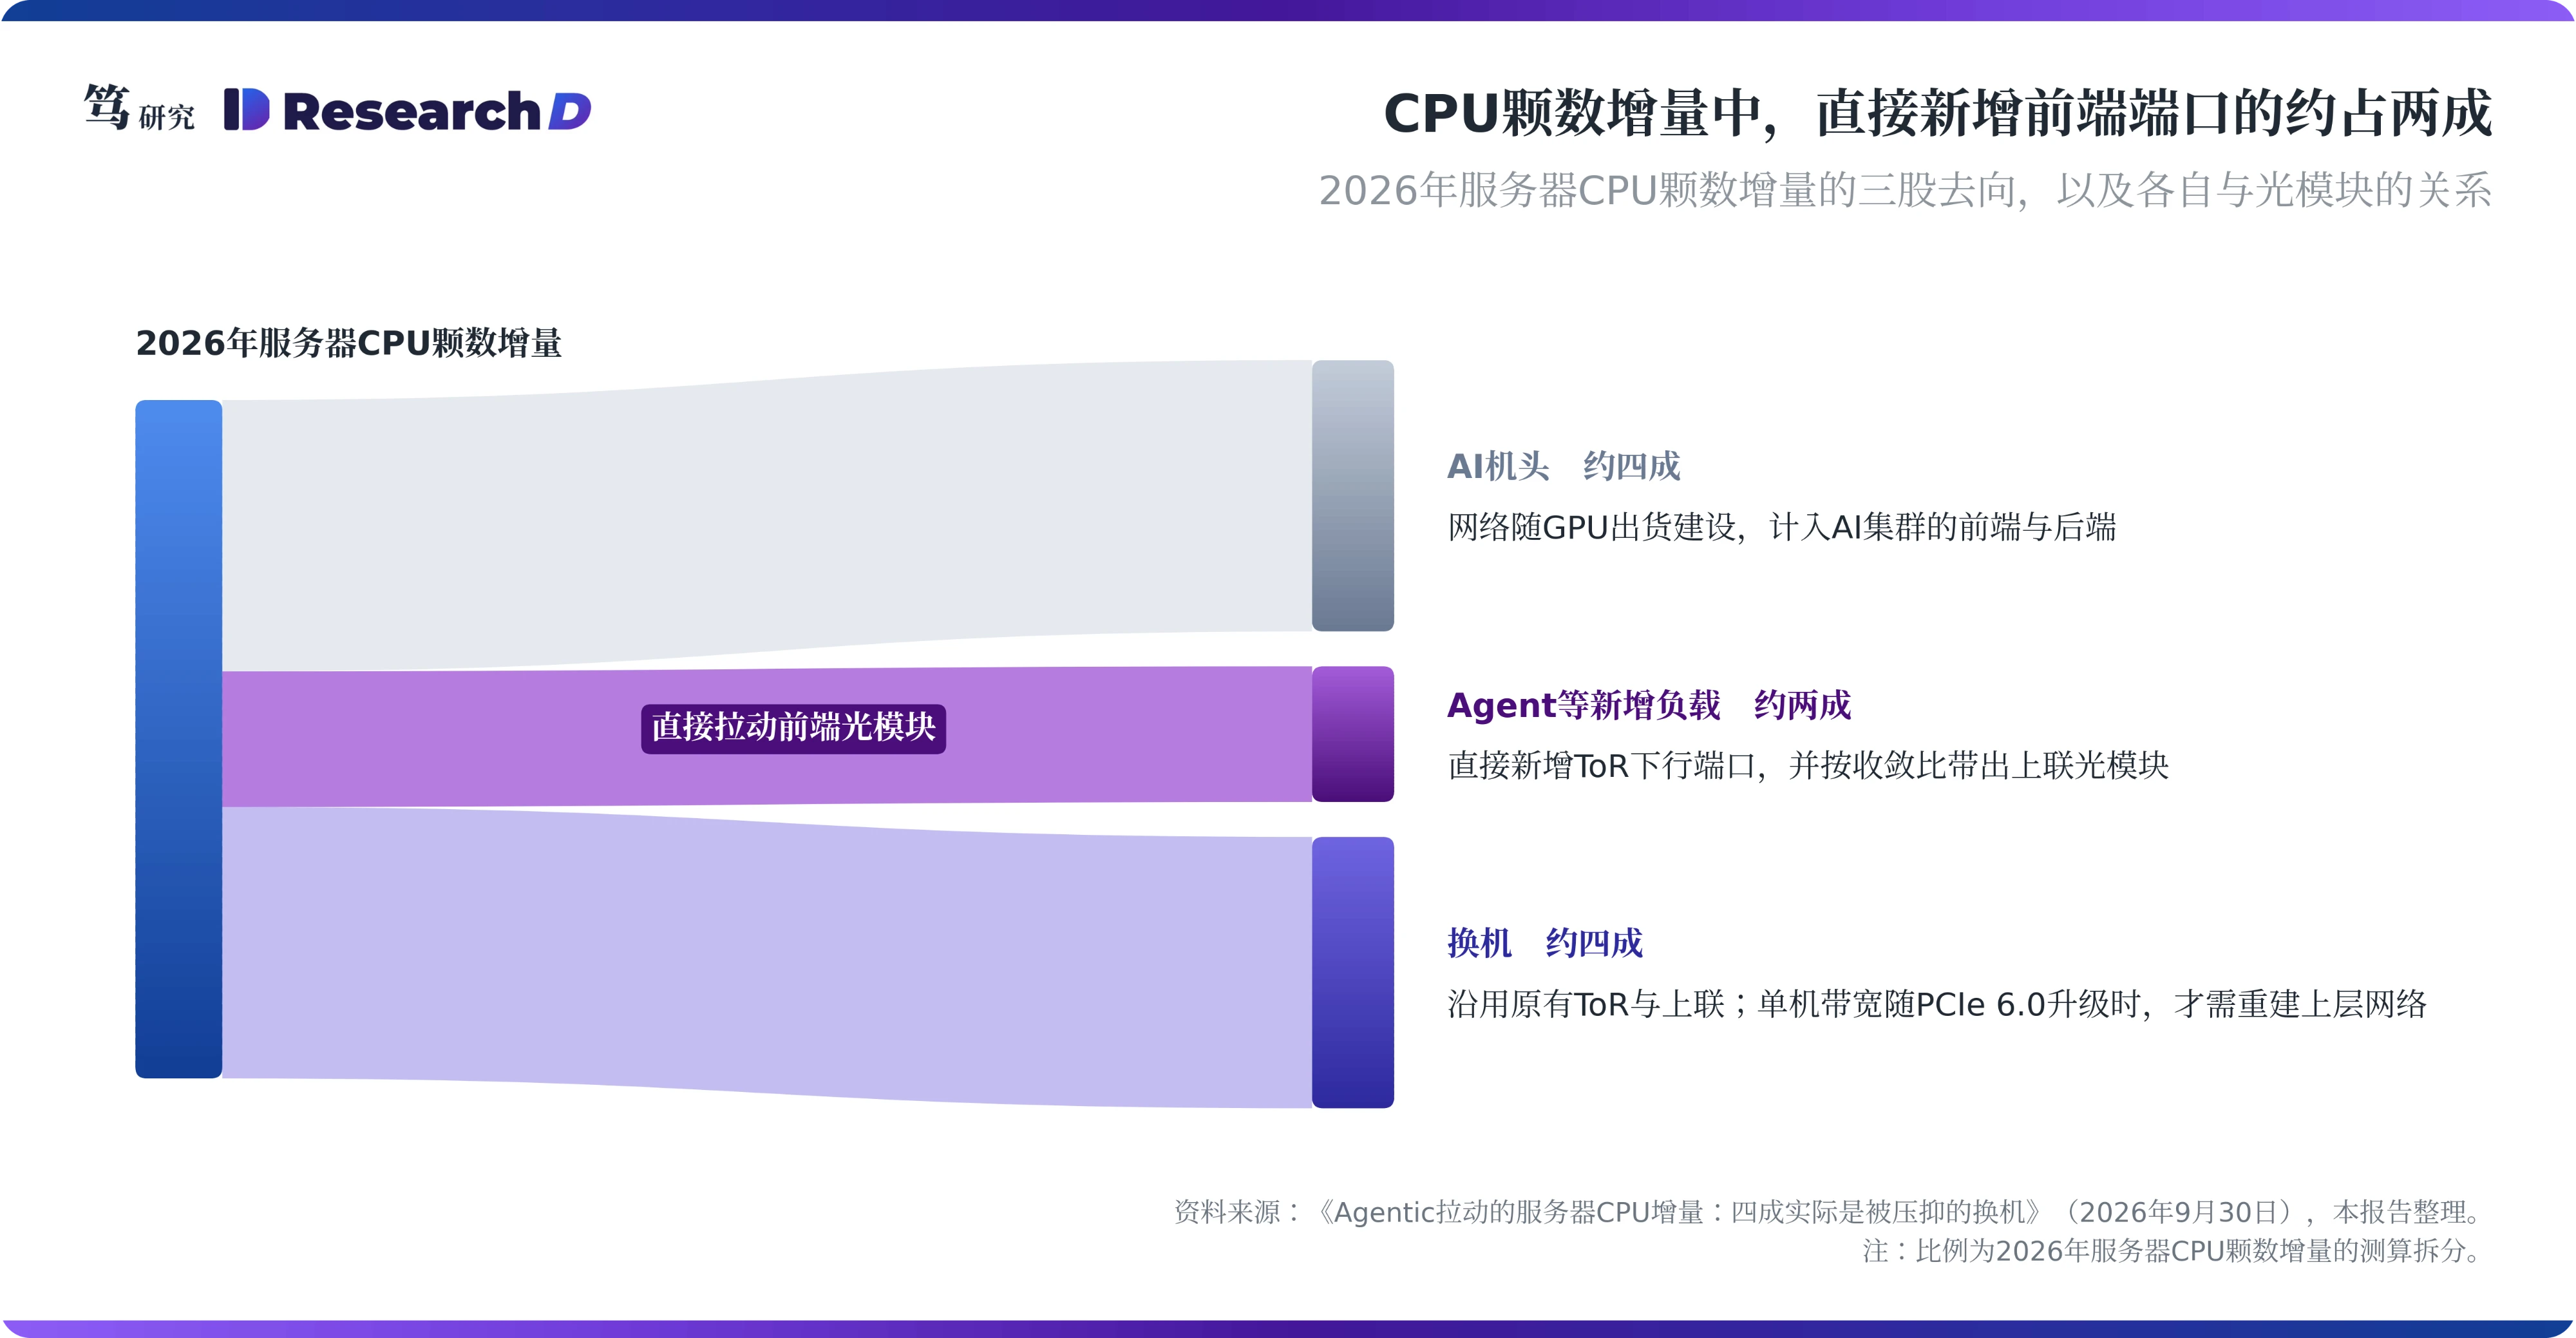
CPU增量按去向分为三股,直接新增前端端口的约占两成。笔者9月30日报告测算,2026年服务器CPU颗数增量中,AI机头约占四成,Agent等新增负载约占两成,换机约占四成。三股去向对光模块的意义各不相同。AI机头的网络随GPU出货建设,计入AI集群;换机沿用原有的ToR与上联,只有单机带宽升级时才需要重建上层网络;直接新增前端端口的,主要是Agent等新增负载那约两成。同一篇报告判断企业端换机在2027年上半年过峰,时间早于英特尔PCIe 6.0平台的推出,本文推测以英特尔为主的企业机群换机大概率在PCIe 5.0平台上完成,带来的光模块增量有限。
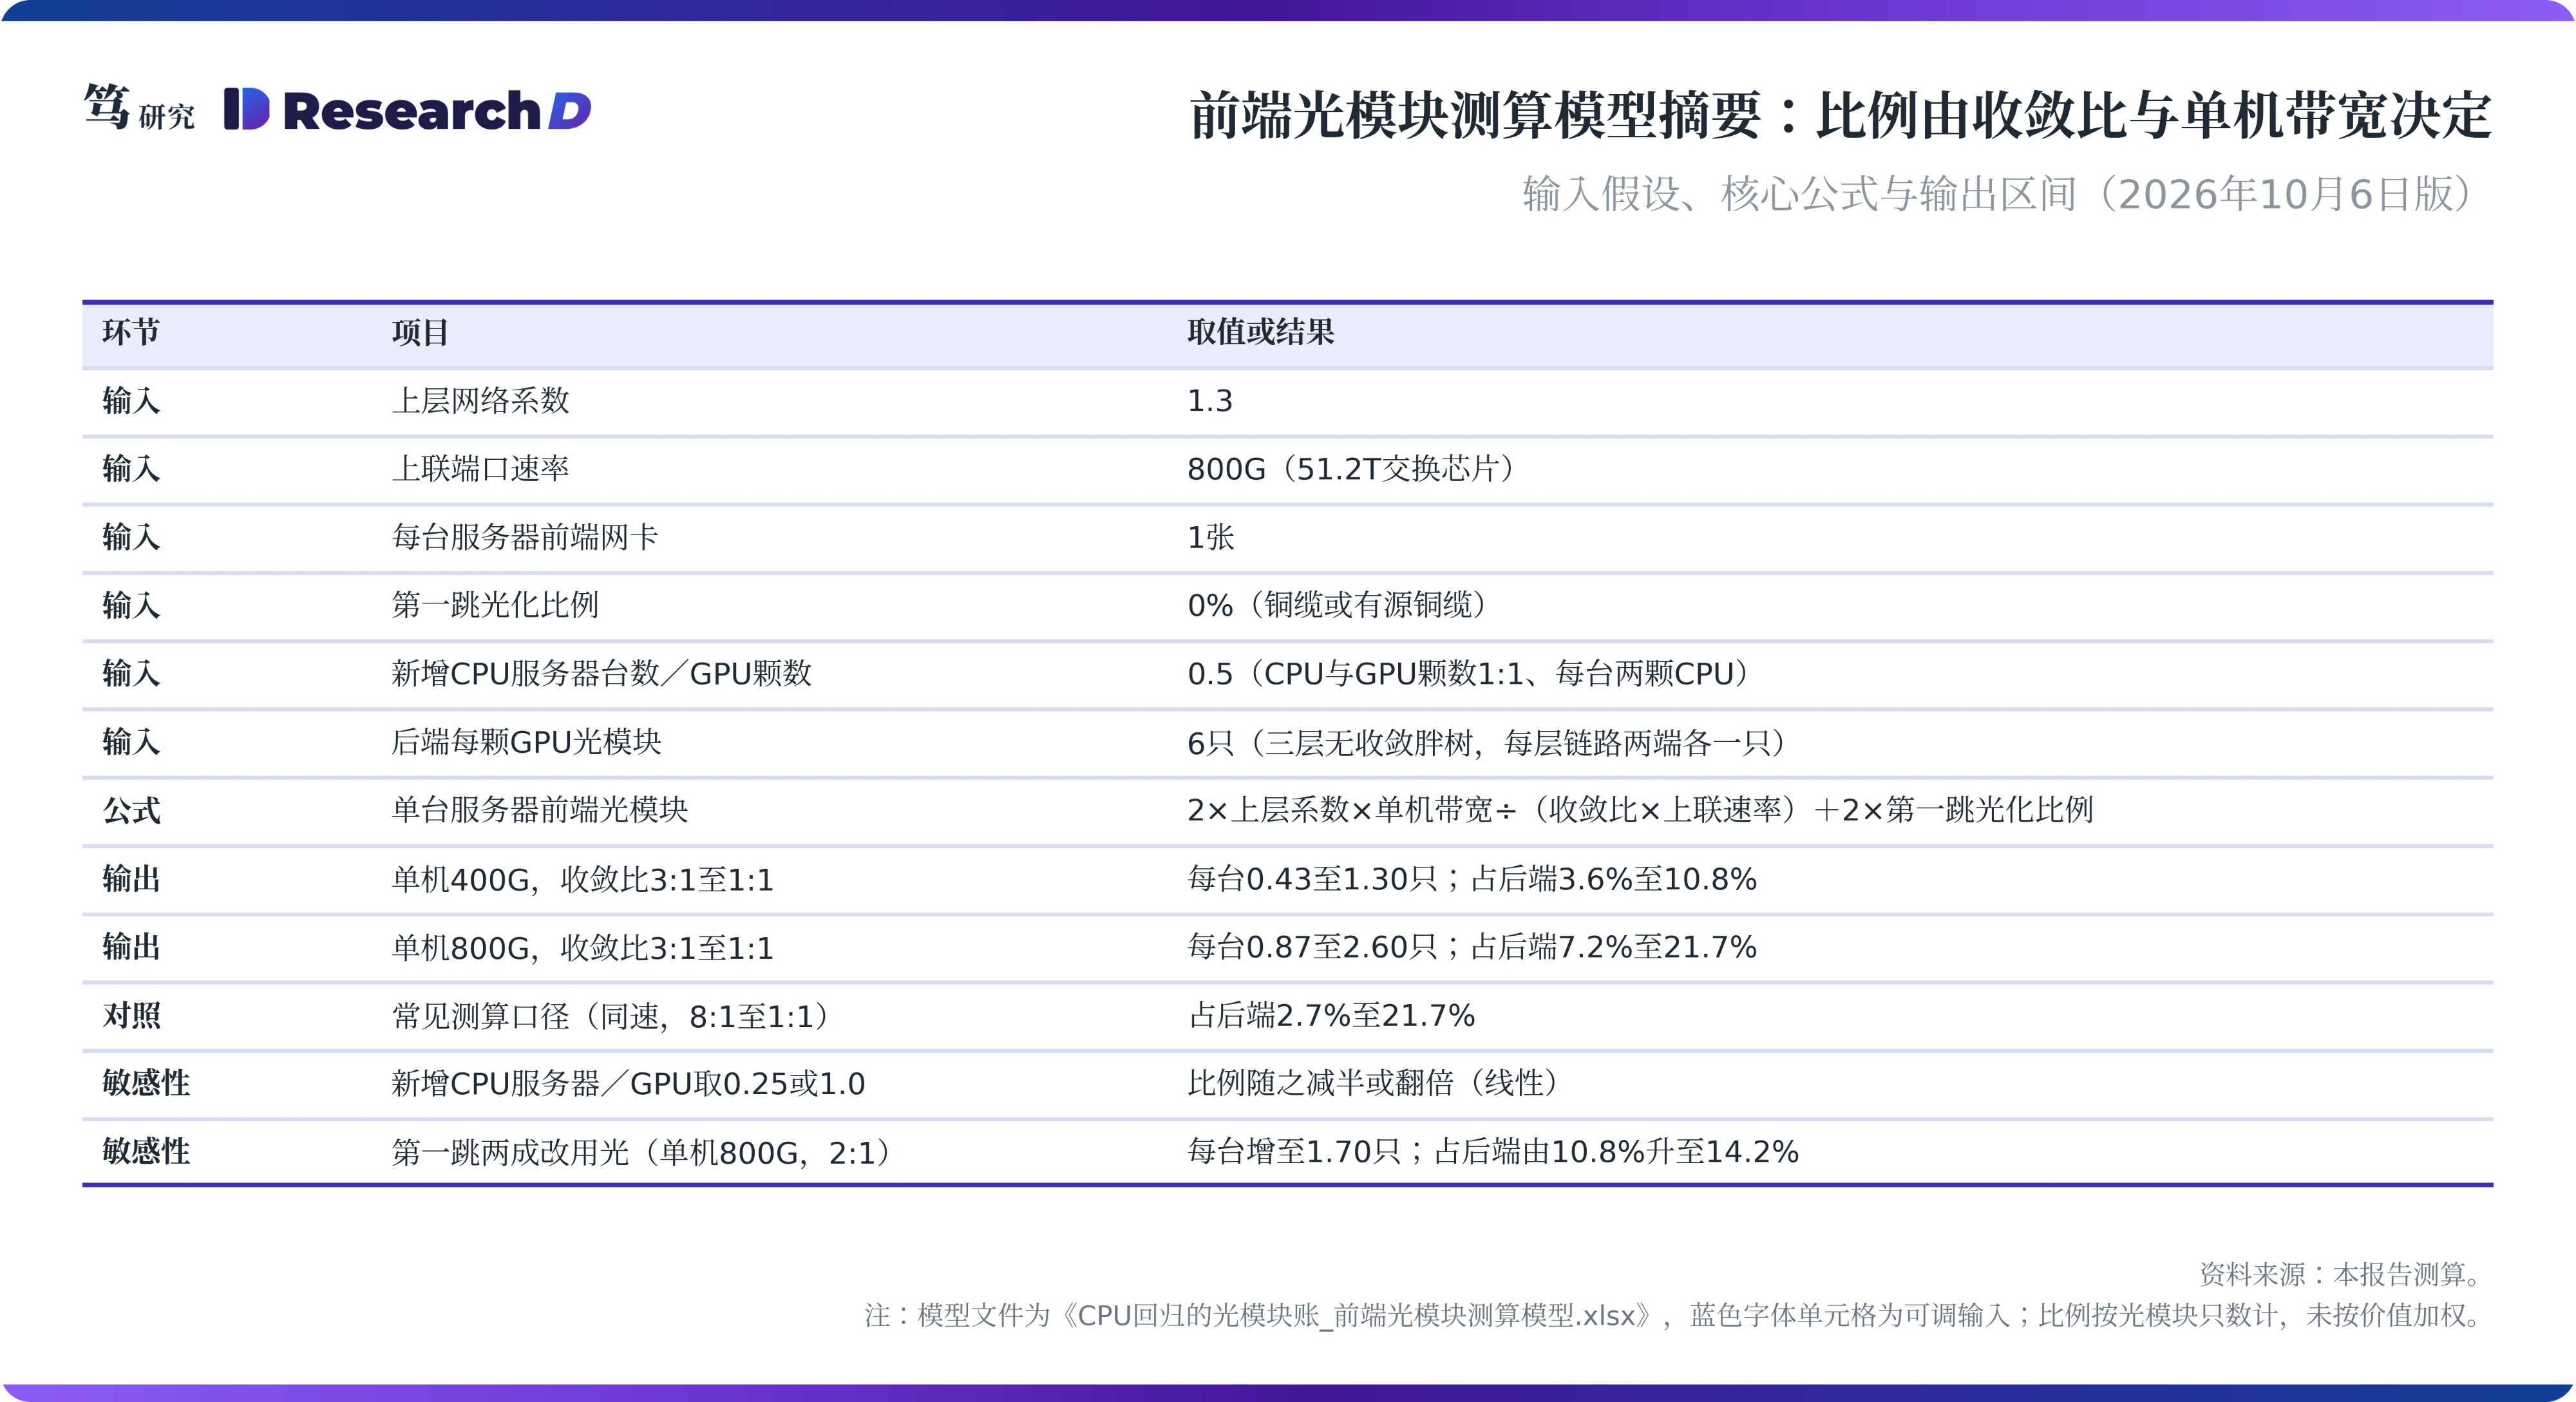
按只数估算,CPU前端增量约为后端的4%到22%。本报告沿用常见的测算框架,调整两项参数(下图)。第一,上联按800G计,收敛比取3:1到1:1;第二,区分单机400G与800G两种情形。其余假设为上层网络系数1.3,新增CPU服务器台数取GPU颗数的一半(对应CPU与GPU颗数1:1、每台两颗CPU),前端上联与后端都按每条链路两端各一只光模块计,后端按三层无收敛胖树计、每颗GPU约6只。估算显示,单机400G时前端增量约为后端的3.6%到10.8%,单机800G时约为7.2%到21.7%。亚马逊云科技通用实例的整机网络带宽仍在百G量级,本文判断通用CPU前端的实际比例落在单机400G一行附近。按价值计,比例还会下修,因为后端正向1.6T迁移。
本文认为,CPU前端是跟随后端的一段增量,量级在后端的一成上下。它抬高的是光模块的总量,价格的主导权仍在后端。CPU回归给光模块带来的增量是真实的,但规模与节奏都由AI集群和CPU平台换代决定,这一点决定了收益在产业链上的分配顺序。
五、换代收益先落在网卡与铜缆,光模块厂拿到的是销量
PCIe 6.0换代最先兑现在网卡与Retimer上。Astera Labs在2026年二季度的PCIe 6产品已占营收一半以上,一季度约为三分之一;三季度收入指引为5.4亿至5.6亿美元,其中包括面向800G有源铜缆的Taurus预量产出货。这部分收入目前主要来自AI机柜,预计通用服务器换到PCIe 6.0后会形成第二段需求。800G网卡与DPU按服务器台数放量;澜起科技的PCIe Retimer处在同一次平台换代上,受益的是其互连类芯片业务,这块业务按服务器平台计价,独立于光模块的价格周期。
第一跳转向有源铜缆,增量随网卡换代同步兑现。Credo给出的2027财年二季度收入指引为5.25亿至5.35亿美元,全年增长目标维持在85%以上;Astera Labs也提到Taurus在AI与通用计算平台上的出货量都在增加。单机带宽每升一档,机柜内超出无源铜缆距离的第一跳就要换成有源铜缆,这部分需求与网卡换代同步出现,时间上排在上联光模块之前。
前端800G停留在100G单通道,与1.6T争夺的3nm DSP和200G光芯片错开。100G单通道的800G DSP在7nm与5nm上量产已久,Marvell的Spica系列即是一例;200G单通道的主力DSP(Marvell Ara、博通Sian3)则是3nm。据调研了解,800G目前以8×100G为主,1.6T在2026年和2027年的出货预计分别为2,200万到2,400万只和7,000万到7,500万只。笔者9月23日报告判断,100G EML与70/100mW连续光这类产品在2027年转向结构性宽松,时点以下半年的可能性居多。前端增量与这类产品的产能释放大致同期,本文推测它消化的是新增产能,修复的是二线厂的稼动率,对现货溢价的支撑有限。据调研了解,北美云厂倾向把订单交给已有大规模供货记录的厂商,新供应商导入以年计,所以前端订单会先流向已在800G上通过认证的厂商。中际旭创、新易盛的产能优先排给1.6T,前端订单对它们属于补充,利润弹性仍在1.6T;光迅科技、华工科技、东山精密(索尔思)这类二线厂拿到的是销量,毛利率的支撑仍要看1.6T份额。
LPO的落点在前端,放量要等云厂转向成本优先。按Adtran等设备商的技术说明,LPO去掉模块里的DSP,把重定时与均衡交给交换芯片完成;LPO多源协议组已完成100G-DR-LPO与400G-FR4-LPO两项规范,Arista在2026年4月称LPO可把模块功耗降低约六成。据调研了解,LPO在100G单通道下可传约500米,能覆盖800G,但云厂在抢交付的阶段以速度为先,LPO的采用有限,竞争格局稳定、转入精细化运营后才会扩大采用。本文判断LPO是前端的条件性增量,触发点与2027年的供需转松大致同步;对已有LPO量产经验的厂商,它属于期权价值,基准情形里不应计入。
六、风险因素
上行风险来自收敛比与第一跳光化。若云厂把通用集群的收敛比降到1:1并同步换上800G网卡,前端比例会靠近22%的上沿;列尾或列中布局下第一跳改用光连接,也会增加前端光模块,按本报告模型测算,单机800G、收敛比2:1时第一跳两成改用光,前端比例由10.8%升至约14.2%;Agent负载的单机带宽若随检索与工具调用上升,PCIe 6.0的数量效应会提前兑现。
下行风险来自核数、带宽节奏与供需。单颗CPU的核数大幅提高,Clearwater Forest为288核,Venice与Diamond Rapids最多256核,Graviton5为192核,同样的算力需求对应的服务器台数随之下降;平台换代后单机带宽若只小幅上调,数量效应会被摊薄;业内对光模块供需平衡点的判断从2027年到2029年不等,一旦转松,前端标准品价格先承压。另外,若光模块被FCC整类列入涵盖清单,我们推测标准化程度高、合格供应商多的前端产品会最先被更换供应商。
七、跟踪三组信号:云厂网络设计、CPU平台出货与前端端口结构
未来半年有三组信号可以检验本文判断。第一组是云厂网络设计,10月的OCP全球峰会与云厂论文会披露前端架构与收敛比;第二组是CPU平台出货,看英特尔与AMD三季报里Venice的云端部署和Diamond Rapids的时间表,以及12月初re:Invent上Graviton5网络优化实例的单机带宽是否超过600Gbps;第三组是前端端口结构,看Dell'Oro季度数据中前端800G端口的占比以及AI与非AI的拆分,Astera Labs与Credo季报中PCIe 6与有源铜缆在通用服务器上的表述。
三种情形会动摇本文判断。一是通用CPU前端在PCIe 5.0平台上规模部署800G,说明插槽限制已被普遍绕开;二是非AI前端的800G端口增速与AI前端相当,说明CPU前端可以独立放量;三是云厂披露Agent集群的ToR收敛比在4:1以上,前端比例的下沿会继续下移。
以上内容不构成任何投资建议,请风险自担。