2026.10.07 | AC | LLM | Overseas AI: Dots, Gemini 4 & TPU
原标题:海外模型与应用进展:OpenAI Dots、Gemini 4 与谷歌 TPU
摘要
2026 年 9 月末至 10 月初,海外 AI 在“模型”与“应用”两条线上同时前移——OpenAI 以 Dots 把个人 Agent 从对话助手推进到常驻自主代理品类,谷歌以 Gemini 4 Argon 让旗舰模型重回第一梯队、并以TPU 外供把自研算力变成可售商品;与此同时,模型层因开源分流与降价而收入承压,算力层却依然供不应求,景气与压力出现在产业链的不同位置。
注:以下内容的数字部分,均来自个人搜集整理和行业专家调研,图表为笔者自制,可能存在不准确、不完整的情况,请自担风险
一、核心结论
一句话总结:2026 年 9 月末至 10 月初,海外 AI 在“模型”与“应用”两条线上同时前移——OpenAI 以 Dots 把个人 Agent 从对话助手推进到常驻自主代理品类,谷歌以 Gemini 4 Argon 让旗舰模型重回第一梯队、并以 TPU 外供把自研算力变成可售商品;与此同时,模型层因开源分流与降价而收入承压,算力层却依然供不应求,景气与压力出现在产业链的不同位置。
行业正在发生的六件事(速览)
- 个人 Agent 跨过品类边界:OpenAI Dots 于 9 月 29 日开发者大会落地,与 Meta Muse、xAI Grok Bot 形成海外三强。
- 需求端已被数据验证:Muse 累计下载突破 560 万、日活接近 200 万(10 月初);Grok Bot 日活七周内由约 6 万升至约 53 万;Dots 起步即面向高付费企业用户。
- 谷歌旗舰模型回归:Gemini 4 Argon 于 9 月 30 日发布,独立智能指数追平 GPT-6 Astra。
- 谷歌 TPU 从内部工具变为商业化引擎:2026 年出货放量,Anthropic、OpenAI、Meta 等外部客户结构成型。
- 模型层收入承压:开源模型分流闭源流量叠加头部厂商降价,头部模型三季度收入环比下滑。
- 算力层依然紧张:订单已排至 2027 年三、四季度,但云厂商资本开支增速预计从高位回落至 20%-30%。
最重要的三个判断
判断一:个人 Agent 的胜负手已从“模型多强”转向“执行可靠性 × 生态连接 × 单位成本”。专家一手体验提供了直接证据——Dots 搭载 GPT-6 Astra,模型能力并不弱,却因缺少工具决策专项训练、资源调用优先级混乱,完成同一个“可佩戴 3D 戒指”建模任务耗时约 50 分钟,而成熟建模软件内嵌大模型仅需 5-10 分钟。模型强不等于任务快,Agent 的产品力由“调度能力”决定。
判断二:谷歌正形成“模型 + 芯片 + 云”的全栈闭环,TPU 外供是这个闭环的变现出口。TPU 单芯片算力弱于英伟达(V8 约为 B200 的 40%),胜负手在网络规模与整机性价比——谷歌目标是把 TPU 的整体性价比做到较 GPU 高 20%-30%;同时 TPU 系统销售已计入云收入,收入弹性远大于模型降价带来的压力。
判断三:“模型收入下滑”与“算力供不应求”并行,不是矛盾,而是价值在产业链上的再分配。开源拉低了模型层的定价权,但训练与推理的算力消耗并未减少,价值正从模型层向芯片与云基础设施层迁移。这解释了为什么同期 TPU 外供放量与模型收入下滑可以同时成立。
二、OpenAI Dots 落地:个人 Agent 跨入“自主代理”品类
海外个人 Agent 的竞争在 9 月末完成了一次正面碰撞:Meta Muse 火了近一个月后,OpenAI 掏出对标产品,三强格局正式成型。
发生了什么:当地时间 9 月 29 日,OpenAI 在开发者大会 DevDay 2026 上发布常驻代理 Dots。Dots 不再在对话窗口等待指令,而是运行在独立云端电脑与浏览器上,围绕预设目标 7×24 小时持续推进;通过 ChatGPT 插件生态接入 4000 多个应用,用户可在 ChatGPT 桌面端、网页端、移动端以及 Slack、Microsoft Teams 与之交互,短信入口即将开通;对话本身不计入 ChatGPT 消息额度。首批面向 ChatGPT Pro(200 美元/月)、Business Premium(125 美元/月)与 Enterprise 用户开放,并新增 500 美元/月的 Pro 500 档位。
为什么是变化:Dots 把“自主代理”作为独立产品形态推出,而非对话助手的延展——这标志着个人 Agent 正式跨越品类边界。与 Meta 仍停留在“对话增强”阶段不同,OpenAI 已把产品推向“交给 Agent 一个持续目标、由它自行拆解推进”的形态;两者的差异不只是产品形态之争,更是渠道与能力的战略分岔——Meta 押注消费级分发,OpenAI 押注企业级能力。
专家一手细节(增量):专家提供了公开渠道难以获得的实测信息。其一,虚拟机配置——存储 32G(已用 16G)、CPU 为 AMD EPYC 9V74(80 核,分配给用户 5 个可用线程)、内存约 10G(常规开启浏览器占用约 2.5G)。其二,预装软件——全部为开源工具,覆盖 3D 建模(3D Slicer、Blender、CAD)、图像与矢量(GIMP、Inkscape)、视频(Kdenlive)、游戏引擎(Godot)、科学可视化(ParaView)、地理分析(QGIS)等,均为本地安装而非在线网页,用户可自行安装其他软件。其三,效率表现——生成一只带穿孔的 3D 戒指模型耗时约 50 分钟,而成熟建模软件内嵌大模型完成同一任务仅需 5-10 分钟,瓶颈在于虚拟机性能有限、AI 模拟人类操作“面向人设计的界面”消耗大量算力,以及多任务并行挤占资源。其四,资源选择混乱——Dots 缺少专门的工具决策训练,会优先尝试在用户本地电脑安装工具,而非调用云端虚拟机的预装资源,关闭本地控制权后才回到云端预装工具。其五,透明性不足——运行过程不显示 token 消耗,账号使用量无明显变动,暂无明确速率限制。
市场认知差:公开叙事聚焦“4000 应用、500 美元档位、年化收入破 400 亿美元”等平台化数字;专家的判断更偏保守——Dots 属“紧急推出、打磨不足”的产品,未针对 Agent 场景做专项优化,尚未回应“已有 Cursor 等编程工具为何还需要 Dots”的质疑,其整合性优势尚未体现。专家同时给出一条机制判断:驱动成熟开源软件完成任务的效果显著优于纯代码生成(游戏开发、建模、绘图等场景尤甚),因为成熟软件的内置功能可大幅降低出错率——这恰恰说明 Dots 的短板不在模型,而在工具调度。(专家观点;公开报道亦指出 OpenAI 复用并重新包装了 Codex 与 ChatGPT 中已有的 Agent 技术)
三、个人 Agent 三强对比:10 月以来最新数据
本节只汇总 2026 年 10 月 1 日以来 OpenAI Dots、Meta Muse、xAI Grok Bot 三款产品的最新公开数据。
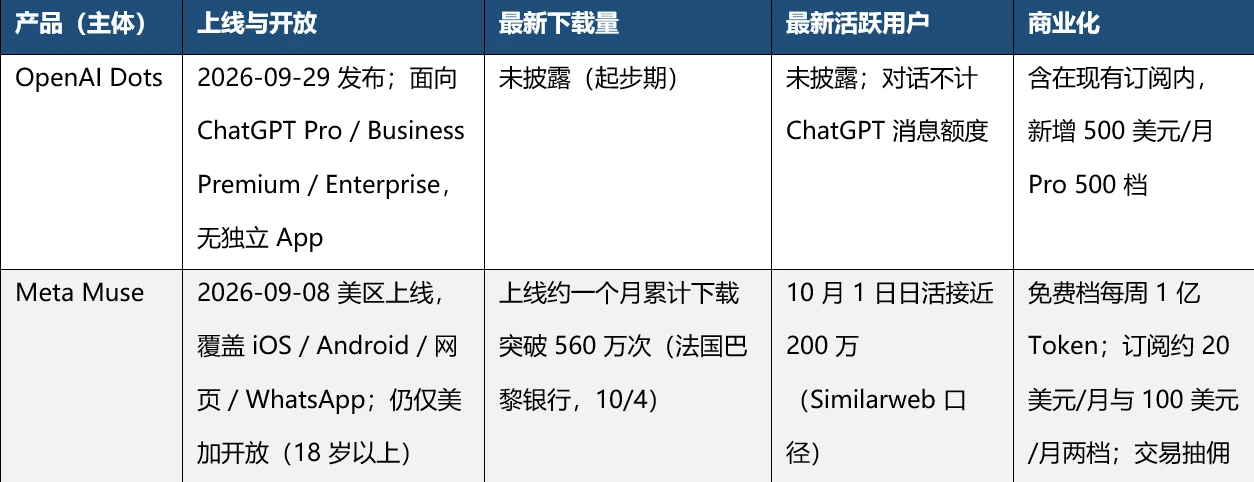
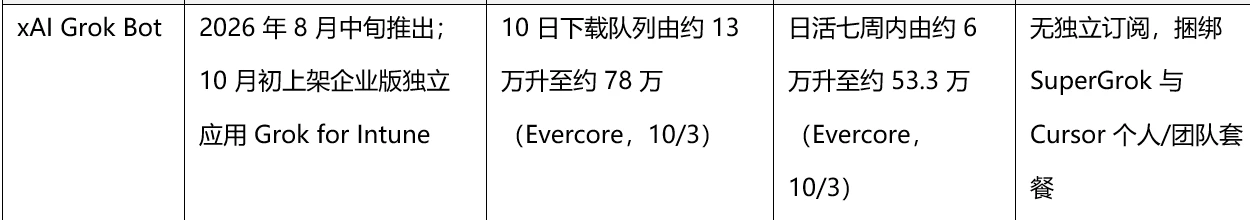
为什么是变化:进入 10 月,两条曲线的方向出现分化。Muse 的规模仍在扩张、累计下载突破 560 万次,但第三方跟踪显示其日活在上线第 15 天即触及增长平台期(ChatGPT 半年后才遇到),并在 9 月 24 日达峰后回落——“下载量”与“使用深度”开始分离,这被视为其单位经济能否成立的核心观察点(摩根士丹利测算每用户成本约 37 美元)。Grok Bot 则仍处爬坡期,日活七周内由约 6 万升至约 53 万,被 Evercore 视为“被低估的常驻代理机会”。
口径提示:三家数据来自不同监测机构(Similarweb、法国巴黎银行、摩根士丹利、Evercore)与不同统计截点,不可直接横向相加或比较。尤其注意:Muse 的“日活接近 200 万”为 Similarweb 全平台独立访客口径,与其移动端口径不可等同;Grok Bot 的“日活约 53.3 万”为日活跃口径,与周活跃口径属不同计量对象,不能互相换算。使用时须标注口径与截点。
同期关键变化:Muse 的生态在扩张的同时出现结构性摩擦——沃尔玛、百思买、Gap、丝芙兰、Wayfair 等零售商签约,支付接入 Shop Pay 与 PayPal,但亚马逊在 Muse 上线不到两周内切断了其访问,显示 Agent 商务涉及平台核心利益、并非单纯技术问题。Grok Bot 方面,企业版独立移动应用 Grok for Intune 已于 10 月初上架,面向组织级部署场景。
四、Gemini 4 Argon:谷歌旗舰模型回到第一梯队
发生了什么:当地时间 9 月 30 日,谷歌 DeepMind 发布 Gemini 4 系列首款旗舰模型 Gemini 4 Argon,主打软件工程、企业知识工作与网络安全防御。发布形式为直接上线、无专门发布会,且未采取“先发低配、再迭代”的分步策略,直接推出能力最强的版本,进度快于原计划的 2026 年 11 月。Argon 暂未全面开放,先通过 Fairwind 计划向受信任的网络安全防御机构开放,待安全护栏完善后再逐步扩大开放范围。
为什么是变化:谷歌上一代旗舰 Gemini 3 发布于 2025 年 11 月,此后主要更新 Flash 系列;原定的 Gemini 3.5 Pro 一再推迟、最终被放弃,谷歌在前沿模型上沉寂约 7 个月。Argon 是谷歌对“已经掉队”这一大众印象的集中回应——独立评估机构 Artificial Analysis 的智能指数给出 53 分,追平 GPT-6 Astra 与 Fable 5.1,比 GPT-6.1 Sol 高 1 分;在谷歌公开的 18 项基准中领先 12 项、并列 1 项。同期 OpenAI 与 Anthropic 快速迭代,谷歌需要用一次“回到第一梯队”的发布重建市场信心。
专家增量(性能提升的机制):专家口径:其一,基模参数量从 Gemini 3 的不足 1T 提升至 Gemini 4 的超过 5T,接近 10 倍量级,是能力跃升的根本原因——前代即便做大量后训练也难以实现突破;其二,人员变动后研发更聚焦,公司资源集中投向 Gemini 的开发与商业化,内部阻力减少;其三,编码数据与具身智能相关的物理世界数据持续积累;其四,针对 web coding 等高度依赖缓存的场景做了工程调整,大幅提升缓存命中率。专家还给出一个具体的短板修复指标:上一代模型在复杂任务上的完成率低于同期第一梯队水平约 10 个百分点,Gemini 4 该指标已无明显短板。(专家口径;参数量 、完成率需跟踪验证)
价格与成本:Argon 首发优惠价为每百万输入 2 美元、输出 10 美元(缓存输入 0.10 美元),优惠结束后回归 4 美元 / 20 美元。按首发折扣,完成一个任务的平均成本约 1.99 美元,为 GPT-6 Astra 的 60%;但促销结束后标准价与 Claude Opus 5.5 持平,每任务成本约为 Astra 的 1.2 倍——“分数追平、账单先薄后厚”是本轮发布容易被忽略的一点。
五、谷歌 TPU:从内部工具到商业化引擎
出货与产能:专家给出的口径是:2026 年 TPU 整体出货约 450 万颗(其中 80% 为 V7,V8 于 2026 年四季度开始交付且以自用为主);2027 年交付 700-800 万颗(已考虑 HBM 产能受限),若 HBM、封装产能缓解,乐观情形可达 1200-1300 万颗;2027 年四季度将对外交付两颗 V8I 打包的推理芯片。公开口径方向一致、数值略有出入:摩根士丹利测算 2026 年全球 TPU 总出货约 370 万颗、2027 年 735 万颗以上,并将谷歌 2027 年 TPU 产量预测上调至 500 万块、2028 年 700 万块;富邦投顾则估算 2028 年推出的第九代 TPU(v9)目标部署 1200-1500 万颗。专家口径略高于公开,但均指向同一结论——TPU 进入放量周期。
为什么是变化:TPU 的角色发生了迁移:从“谷歌自用工具”变成“可对外销售的商业化引擎”。谷歌已宣布 TPU 系统销售计入云收入,并于二季度开始向客户数据中心交付;外部客户结构成型——专家称 2026 年 TPU 逾 70% 自用、约 30% 对外,对外 150 万颗中 OpenAI 相关需求约占 100 万颗;公开口径为 Anthropic 2026 年部署 1GW Ironwood、2027 年再部署 5GW、2028 年增量 10GW,OpenAI 按计划 2027 年推进 1.3GW。分析师口径的 TPU 相关基础设施收入提升是本轮最大的收入弹性来源之一。
价格与技术:专家给出较细的价格与参数口径:V8 打包折算单颗芯片对外售价约 7-8 万美元(含网络等配套,不可与纯 GPU 计算卡直接比较);V7 以租赁为主、约 2.3-2.5 美元/颗/小时且近期涨幅超 30%,仅面向大客户;V8T 租赁价格较 V7 增长 50% 以上。技术层面,V7 使用 HBM3、V8 使用 HBM3E,落后英伟达 Rubin 的 HBM4(HBM4 产能被英伟达提前预订);纯芯片算力上 V8 约为 B200 的 40%,该差距预计到 V9 才能缩小,但谷歌依托更大规模的 scale-out 网络,目标是把 TPU 的整体性价比做到较 GPU 高 20%-30%;V8 在 FP4、FP8 下算力较 V7 提升,但 FP16 下弱于 V7。下一代 V9 延续训练(V9T)、推理(V9I)双线,集群规模从 V8 的 1152 卡缩小至 256 卡,V9T 引入 6D 网络拓扑、单芯片 12 根链路以减少通信跳数。TPU 设计生命周期 6 年,实际稳定性优于 GPU(部分 V3 已服役超 6 年)。(专家口径;单颗售价、租赁价、集群参数待跟踪)
瓶颈与供应链:当前核心瓶颈是 HBM 与 CoWoS 封装产能,谷歌已尝试将部分 V8 交英特尔封装以降低对台积电的依赖。公开信息亦印证了这一转向:谷歌 TPU 明确采取“以英特尔 EMIB-T 为主、台积电 CoWoS 为辅”的双路径,联发科参与的新一代 TPU 预计 2027 年四季度推出。电力方面,2027 年全球电力供应较 2026 年缓解,但欧美仍紧张,谷歌正评估将部分 TPU 部署至马来西亚、泰国等亚太数据中心。(专家口径;与公开“EMIB-T 双路径”方向一致)
六、模型商业化承压:降价、开源分流与算力供需
与算力端的景气相反,模型端的收入正在承受压力。理解这一“背离”,是判断海外 AI 价值分配的关键。
谷歌云的业务结构(专家增量):专家给出的细分口径是:AI 算力与模型相关业务是增长核心,2026 年底 AI 算力贡献的收入将首次超过普通 CPU 业务;CPU 业务受 AI 拉动但受限于货源,难以成为增长主力;存储业务因硬盘紧缺实行配额制,全年资源增长约 30% 且全部售罄;PaaS 层(容器、数据库、缓存)因依赖底层资源叠加需求向 AI 转移,原定 40% 的同比增速只能做到约 30%;安全业务增速较好。整体看,谷歌云此前季度增速超 80%,2026 年二、三季度为密集资源交付周期,后续仍将保持较高同比增速。(专家口径;公开口径为谷歌云二季度收入 248 亿美元、同比 +82%,方向一致)
模型层为何承压:专家判断:2026 年二季度大模型行业出现非理性需求爆发(当时 AI 算力需求是供给的 10 倍),当前需求逐步回归理性;头部闭源模型三季度收入较二季度下滑,四季度预计难以企稳回升。原因有二——一是开源模型能力提升分流闭源模型流量,二是二季度需求本身存在泡沫。同时,头部模型厂商均有不同程度降价,Gemini 3.7 的列表价已降至 3.5 版本的一半,对模型厂商收入增长构成压力。(专家口径,需跟踪验证)
算力层为何依然紧张:与模型收入承压相反,算力供给依然远小于需求:当前订单已排至 2027 年三、四季度,更早时段已无可用资源,正在洽谈的都是万卡级项目。资本开支层面,行业整体增速将逐步放缓,若没有新的爆款 AI 业务出现,预计后续行业资本开支增速将回落至 20%-30% 区间。(专家口径)
市场认知差:市场容易把“模型降价、收入下滑”与“算力景气”看成矛盾信号;实际上二者并不冲突——开源拉低的是模型层的定价权,而训练与推理的算力消耗并未减少,价值正在从模型层向芯片与云基础设施层迁移。这解释了为什么同期 TPU 外供放量与模型收入下滑可以并存。
风险提示:以上内容仅为个人学习总结,不构成任何投资建议。